
최장 증가 수열 (LIS)
최장 증가 수열(LIS, Longest Increasing Subsequence)은 배열에서 순서를 지키며 몇 개를 골랐을 때, 값이 계속 커지는 가장 긴 부분 수열을 찾는 문제입니다.
한눈에 보기
최장 증가 수열: 가장 긴 증가하는 부분 수열
- 부분 수열: 원래 순서는 그대로 두고, 중간 원소를 건너뛰며 골라낸 수열입니다. 붙어 있을 필요는 없습니다.
- 증가: 앞의 값보다 뒤의 값이 커야 합니다. (이 글은 같은 값을 허용하지 않는 "엄격한 증가" 기준)
비유하면, 줄 서 있는 사람들 중 몇 명만 남겨서 앞에서 뒤로 갈수록 키가 커지게 만들고 싶을 때, 최대 몇 명까지 남길 수 있는지 묻는 문제입니다. 자리를 바꿀 수는 없고 빼기만 할 수 있습니다.
[7, 2, 3, 8, 4, 5] → 이 배열에서는 [2, 3, 4, 5]가 LIS로 답은 4입니다.
[2, 3, 8]도 증가하는 부분 수열이지만 길이가 3이라 가장 길지는 않습니다.
구현 방법 (시간복잡도)
- DP: O(N^2)
- Lower Bound(이분 탐색): O(N log N)
동작 과정
DP 방식
동적 계획법으로 "dp[i] = arr[i]로 끝나는 가장 긴 증가 수열의 길이"를 채웁니다.
- 모든
dp[i]를 1로 시작합니다. (자기 자신 하나만 있어도 길이 1) i보다 앞에 있는j를 모두 보면서,arr[j] < arr[i]이면arr[j]로 끝나는 수열 뒤에arr[i]를 붙일 수 있습니다. 그러면 길이는dp[j] + 1입니다.- 그중 가장 큰 값을
dp[i]로 정합니다. - 마지막에
dp전체의 최댓값이 답입니다.
arr = [7, 2, 3, 8, 4, 5]
| i | arr[i] | 앞에서 이어 붙일 수 있는 값 | dp[i] |
|---|---|---|---|
| 0 | 7 | 없음 | 1 |
| 1 | 2 | 없음 | 1 |
| 2 | 3 | 2 (dp=1) | 2 |
| 3 | 8 | 7 (dp=1), 2 (dp=1), 3 (dp=2) | 3 |
| 4 | 4 | 2 (dp=1), 3 (dp=2) | 3 |
| 5 | 5 | 2 (dp=1), 3 (dp=2), 4 (dp=3) | 4 |
dp = [1, 1, 2, 3, 3, 4] → 최댓값 4.
원문 코드는 dp를 0으로 시작해서 저장된 값이 [0, 0, 1, 2, 2, 3]이고, "dp 배열에 저장된 값 중 최댓값 + 1"을 답으로 냅니다. 모든 칸이 1씩 작을 뿐 같은 방법입니다.
Lower Bound 방식
하지만 N^2으로 해결할 수 없는 문제라면? (예: 배열 길이가 최대 10만이면 10만 × 10만 = 100억 번 비교)
이때는 Lower Bound를 활용한 LIS 구현을 해야 합니다. Lower Bound는 정렬된 배열에서 x 이상인 값이 처음 나오는 위치를 이분 탐색으로 찾는 것입니다.
tails[k] = "길이가 k+1인 증가 수열들 중 가장 작은 끝값"을 관리합니다. 끝값이 작을수록 뒤에 더 많은 값을 붙일 수 있으니 유리합니다. tails는 항상 오름차순이라 이분 탐색이 가능합니다.
- 값 x를 하나씩 봅니다.
tails에서 x의 lower bound 위치를 찾습니다.- 위치가
tails끝이면 x가 모든 끝값보다 크다는 뜻이므로, 뒤에 붙여 수열을 한 칸 늘립니다. - 아니면 그 자리의 끝값을 더 작은 x로 바꿉니다. (같은 길이인데 끝값이 더 작은 수열을 찾은 것)
- 끝나면
tails의 길이가 답입니다.
| x | lower bound 위치 | tails | 설명 |
|---|---|---|---|
| 7 | 0 | [7] | 비어 있으니 추가 |
| 2 | 0 | [2] | 7 자리를 더 작은 2로 교체 |
| 3 | 1 | [2, 3] | 끝이므로 추가 |
| 8 | 2 | [2, 3, 8] | 끝이므로 추가 |
| 4 | 2 | [2, 3, 4] | 8 자리를 4로 교체 |
| 5 | 3 | [2, 3, 4, 5] | 끝이므로 추가 |
tails의 길이 4가 답입니다.
아래 애니메이션은 같은 생각을 길이별 후보 수열로 보여 줍니다. 값을 하나씩 읽으면서 길이마다 "끝값이 가장 작은 증가 수열" 하나만 남기고, 같은 길이인데 끝값이 더 큰 후보는 지웁니다(Inactive). 각 줄의 끝값만 모으면 위의 tails가 됩니다.
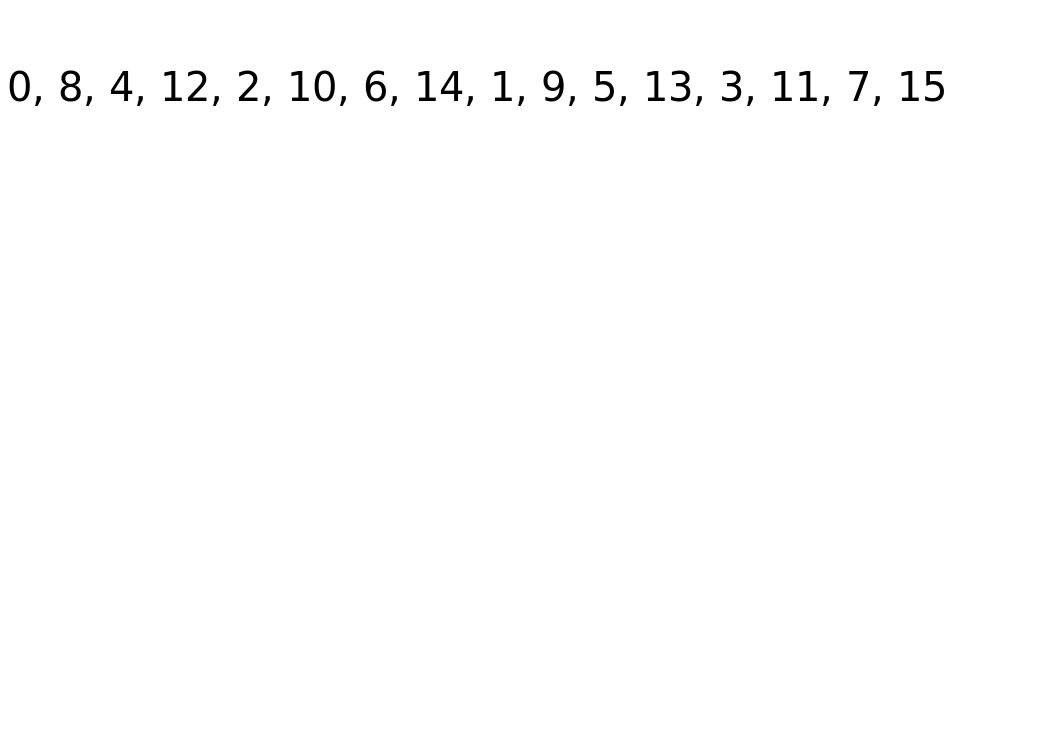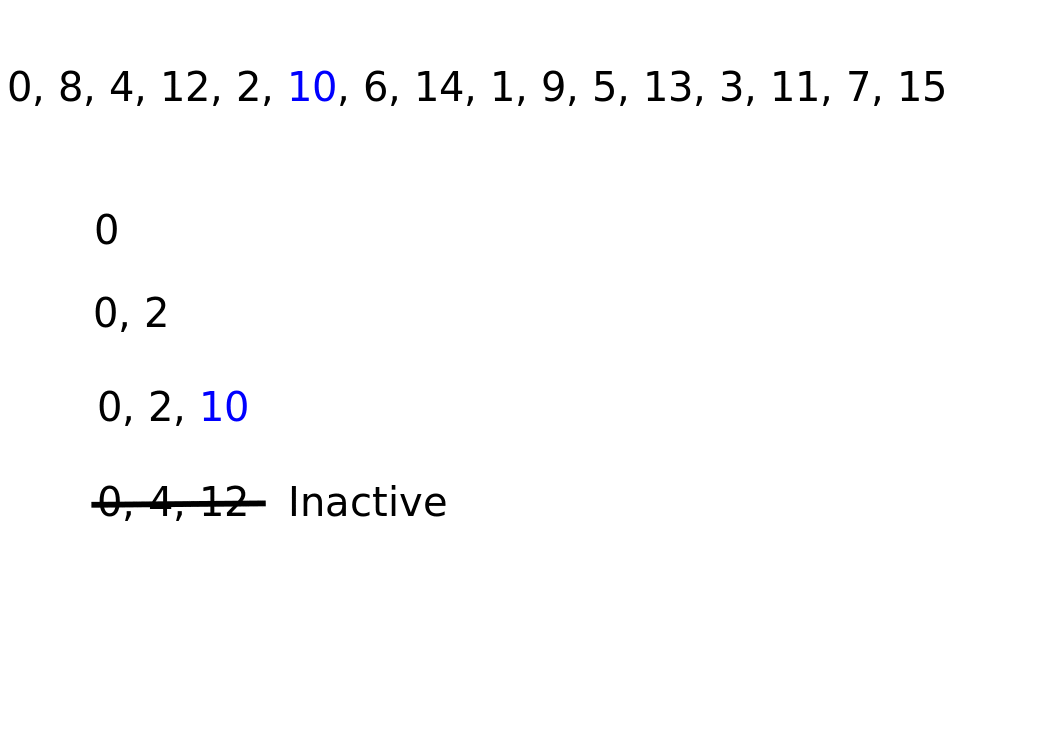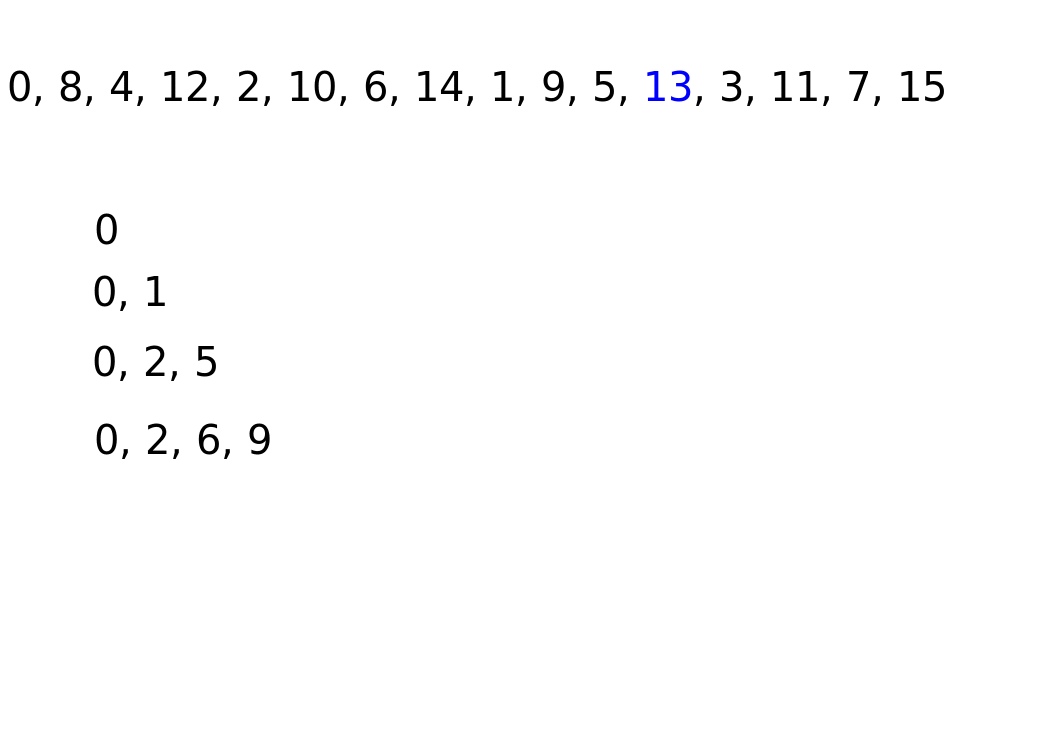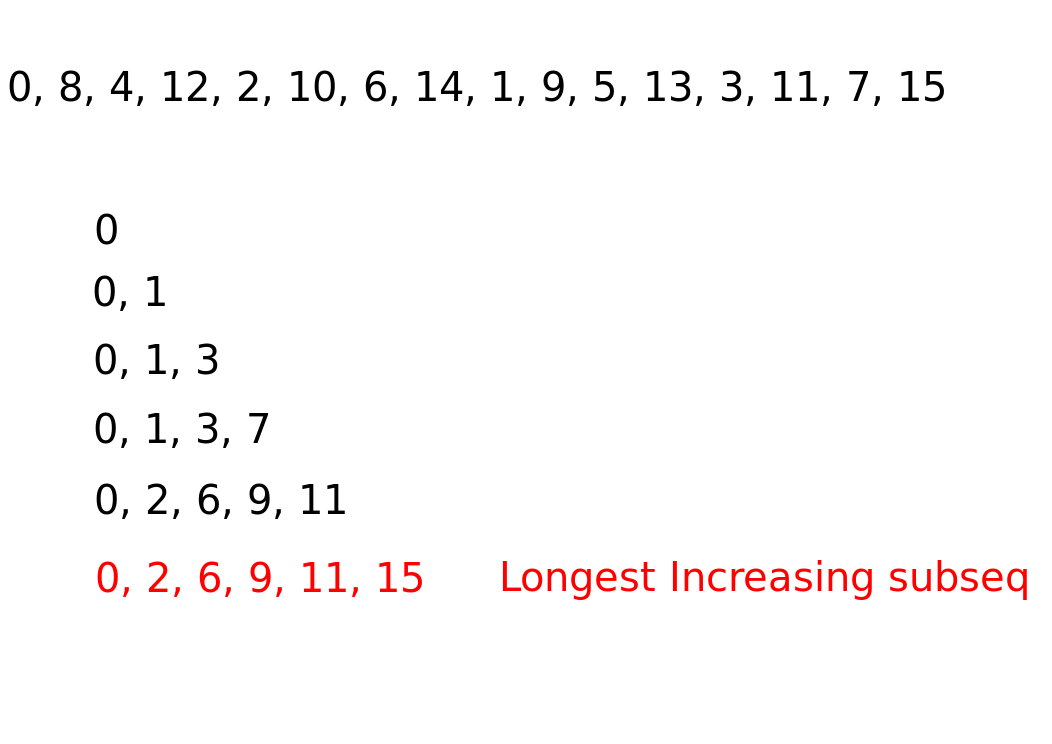
그림 출처: Wikimedia Commons (CC BY-SA 4.0, Shiyu Ji)
주의: tails는 길이를 구하기 위한 도구일 뿐, 실제 LIS 그 자체가 아닐 수 있습니다. 예를 들어 [3, 4, 1]이면 tails는 [1, 4]가 되지만, 1은 4보다 뒤에 있으므로 실제 수열이 아닙니다. (실제 LIS는 [3, 4])
Python 코드
from bisect import bisect_left


# 1. DP 방식: O(N^2)
def lis_dp(arr):
    if not arr:
        return 0
    n = len(arr)
    dp = [1] * n                       # dp[i] = arr[i]로 끝나는 LIS 길이 (자기 자신만 있어도 1)
    for i in range(1, n):
        for j in range(i - 1, -1, -1):
            if arr[i] > arr[j]:        # 2. 앞의 더 작은 값 뒤에 이어 붙일 수 있으면
                dp[i] = max(dp[i], dp[j] + 1)
    return max(dp)                     # 3. 그중 가장 긴 것


# 4. 이분 탐색(Lower Bound) 방식: O(N log N)
def lis_lower_bound(arr):
    tails = []                         # tails[k] = 길이 k+1인 증가 수열의 가장 작은 끝값
    for x in arr:
        pos = bisect_left(tails, x)    # 5. x 이상이 처음 나오는 위치 (lower bound)
        if pos == len(tails):
            tails.append(x)            # 6. 모든 끝값보다 크면 수열을 한 칸 늘림
        else:
            tails[pos] = x             # 7. 아니면 그 자리의 끝값을 더 작은 x로 교체
    return len(tails)


arr = [7, 2, 3, 8, 4, 5]
print(lis_dp(arr))            # 출력: 4
print(lis_lower_bound(arr)) # 출력: 4- 원문과 같은 이중 반복문입니다.
dp를 1로 시작하므로 마지막에 +1 할 필요가 없습니다. 빈 배열이면 0을 돌려줍니다. arr[j]로 끝나는 수열 뒤에arr[i]를 붙이면 길이가dp[j] + 1이 되므로, 지금까지 찾은 값과 비교해 더 긴 쪽을 남깁니다.- LIS는 어느 위치에서 끝날지 모르니
dp전체의 최댓값이 답입니다. - Lower Bound 방식입니다.
tails는 항상 오름차순으로 유지됩니다. bisect_left는 Python 표준 라이브러리의 lower bound 함수입니다.- x가 가장 크면 가장 긴 수열 뒤에 붙일 수 있으므로 길이가 1 늘어납니다.
- 그렇지 않으면 같은 길이의 수열 끝값을 x로 낮춰, 뒤에 올 값들이 붙기 쉽게 만듭니다.
실제 수열까지 구하기
길이뿐 아니라 LIS 자체가 필요하면, DP 방식에서 "누구 뒤에 붙었는지"를 함께 기록해 두었다가 거꾸로 따라가면 됩니다. (원문에는 없는 보충 내용)
def lis_with_path(arr):
    n = len(arr)
    if n == 0:
        return []
    dp = [1] * n
    prev = [-1] * n                    # 1. prev[i] = arr[i] 바로 앞에 온 원소의 위치
    for i in range(1, n):
        for j in range(i):
            if arr[j] < arr[i] and dp[j] + 1 > dp[i]:
                dp[i] = dp[j] + 1
                prev[i] = j
    i = dp.index(max(dp))              # 2. 가장 긴 수열이 끝나는 위치에서 출발
    path = []
    while i != -1:                     # 3. prev를 거꾸로 따라가며 모으기
        path.append(arr[i])
        i = prev[i]
    return path[::-1]


print(lis_with_path([7, 2, 3, 8, 4, 5])) # 출력: [2, 3, 4, 5]dp[i]가 늘어날 때마다 "어느 j 뒤에 붙었는지"를prev[i]에 적습니다. -1은 "앞에 아무도 없음"입니다.- 가장 긴 길이를 가진 위치가 LIS의 마지막 원소입니다.
- 끝에서부터
prev를 따라가면 수열이 거꾸로 모이므로, 마지막에 뒤집습니다.
시간복잡도와 공간복잡도
| 방법 | 최선 | 평균 | 최악 | 추가 공간 |
|---|---|---|---|---|
| DP | O(N^2) | O(N^2) | O(N^2) | O(N) |
| Lower Bound | O(N) | O(N log N) | O(N log N) | O(N) |
- DP 방식은 값과 상관없이 모든 (i, j) 쌍을 비교하므로 항상 O(N^2)입니다.
- Lower Bound 방식은 원소 N개마다 이분 탐색 O(log N)을 하므로 O(N log N)입니다. 배열이 계속 작아지기만 하면
tails길이가 1에 머물러 탐색이 바로 끝나므로 최선은 O(N)입니다. - N = 10만일 때 N^2은 100억, N log N은 약 170만이라 차이가 매우 큽니다. 표기법은 시간 복잡도 글을 참고하세요.
활용 예
- 백준 11053 "가장 긴 증가하는 부분 수열": N이 작아 DP 방식으로 충분합니다.
- 백준 12015 "가장 긴 증가하는 부분 수열 2": N이 커서 Lower Bound 방식이 필요합니다.
- 백준 2565 "전깃줄": 한쪽 전봇대 번호 순으로 정렬한 뒤, 다른 쪽 번호의 LIS를 구하면 "겹치지 않게 남길 수 있는 최대 전깃줄 수"가 됩니다.
- 같은 값도 허용하는 "감소하지 않는 수열"을 구하려면
bisect_left대신bisect_right를, DP에서는>대신>=를 씁니다.
정리
| 개념 | 비전공자 버전 요약 |
|---|---|
| LIS | 순서를 지키며 골랐을 때 점점 커지는 가장 긴 줄 |
| 부분 수열 | 자리는 그대로, 중간을 건너뛰며 골라낸 수열 |
| DP 방식 | "여기서 끝나는 가장 긴 줄"을 앞에서부터 모두 계산, O(N^2) |
| Lower Bound 방식 | 길이별 가장 작은 끝값만 기억하고 이분 탐색으로 갱신, O(N log N) |
| tails 배열 | 길이를 세는 도구일 뿐 실제 LIS와 다를 수 있음 |