
해시 테이블 (Hash Table)
해시 테이블은 입력값을 숫자 키로 바꿔 그 키 자리에 저장해 두고, 찾을 때도 그 자리만 확인해서 탐색 시간을 크게 줄이는 방법입니다.
한눈에 보기
알고리즘 문제를 풀려면 꼭 알아야 하는 개념입니다. 브루트 포스(완전 탐색, 전부 하나씩 비교)로는 시간 초과가 나는 문제에서 해시를 적용합니다.
비유하면 학교 사물함입니다. 이름의 글자들로 사물함 번호를 계산해서 그 칸에 물건을 넣어 둡니다. 나중에 찾을 때는 전교생 사물함을 다 열어 볼 필요 없이, 같은 계산으로 번호를 구해 그 칸만 열면 됩니다.
- 해시 함수: 입력(문자열 등)을 정해진 범위의 숫자(키)로 바꾸는 함수. 사물함 번호 계산법입니다.
- 충돌: 서로 다른 입력인데 같은 키가 나오는 현상. 사물함 하나에 두 사람 물건이 들어가는 상황입니다. 충돌은 최대한 피해야 하지만, 무조건 피할 수 있다는 보장은 없습니다. 그래서 같은 칸 안에 여러 개를 담을 수 있게 만들어 둡니다.
아래 그림처럼 이름(key)을 해시 함수에 넣으면 칸 번호가 나오고, 그 칸에 전화번호(값)를 저장합니다.
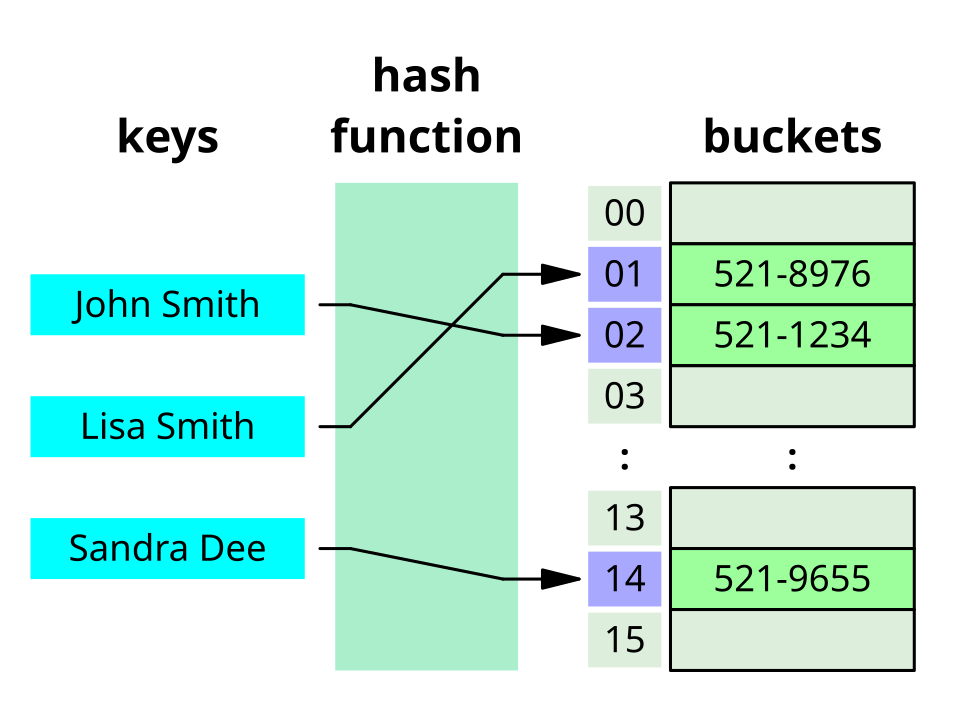
그림 출처: Wikimedia Commons (CC BY-SA 3.0, Jorge Stolfi)
Python의 dict, set이 바로 해시 테이블입니다. 해시맵 자료구조 자체는 해시맵 글에서 더 자세히 다룹니다. 이 글은 원문을 따라 해시 테이블을 직접 구현해서 문제를 푸는 과정을 봅니다.
연습 문제
Codeforces 4C - Registration system
N(1~100,000)개의 문자열이 차례로 입력됩니다. 처음 들어온 문자열은 OK, 들어온 적이 있는 문자열은 문자열+번호로 출력합니다. 번호는 그 문자열이 다시 들어온 횟수(1, 2, 3, ...)입니다.
입력 예
5
abcd
abc
abcd
abcd
ab
출력 예
OK
OK
abcd1
abcd2
OK
문제를 이해하는 건 쉽습니다. 같은 문자열이 들어왔는지 확인하고, 들어온 적 있는 문자열에는 번호를 붙여 출력하면 됩니다.
하지만 N은 최대 10만입니다. 브루트 포스로 새 문자열마다 앞의 모든 문자열과 비교하면 약 N²번, 즉 100억 번 수준의 비교가 필요해 시간 초과가 납니다. 그래서 해시 테이블로 풀어야 합니다. 입력된 문자열을 해시 키로 바꿔 저장하면서 비교 횟수를 최대한 줄이는 것입니다.
해시 테이블을 알고리즘 문제에 적용해 보기에 아주 좋은 연습 문제입니다. 특히 라이브러리 없이 해시 테이블을 직접 구현해야 하는 삼성 상시 SW 역량테스트 B형을 준비한다면 연습하기 딱 좋습니다.
해시 테이블 구현
해시 테이블은 탐색을 최대한 줄이기 위해, 입력마다 key 값을 구해서 그 key 자리에서 관리하는 방식입니다.
크기 정하기
입력은 최대 10만 개입니다. 이것을 1000개의 칸(버킷)으로 나누면 칸 하나에 평균 100개 정도가 들어갑니다. 그래서 1000 × 100 크기의 2차원 배열로 나누어 관리하면 효율적입니다.
충돌 때문에 어떤 칸에는 평균보다 많이 몰릴 수 있습니다. 이를 감안해 원문은 두 번째 크기(칸 하나의 용량)에 4를 곱해 400으로 넉넉히 잡습니다.
| 이름 | 값 | 의미 |
|---|---|---|
HASH_SIZE | 1000 | 칸(버킷) 개수. key는 0~999 중 하나 |
HASH_LEN | 400 | 칸 하나에 담을 수 있는 서로 다른 문자열 수 (평균 100 × 4) |
HASH_VAL | 17 | key를 계산할 때 곱하는 수. 소수로 정함 |
HASH_VAL은 입력값의 key를 구할 때 씁니다. 입력마다 key가 최대한 겹치지 않도록 보통 17, 19, 23 같은 소수를 씁니다. 소수를 곱하면 글자 순서나 조합이 조금만 달라도 결과가 고르게 퍼지는 경향이 있기 때문입니다. 다만 소수를 쓴다고 충돌이 없어지는 것은 아니고, 줄여 주는 요령입니다.
key를 만드는 함수
문자열의 한 글자마다 정수 값(문자 코드)을 얻을 수 있습니다. 이를 이용해 문자열 길이만큼 반복하면서 그 문자열만의 key를 만듭니다. 만드는 방법은 사람마다 다르며, 아래가 유일한 정답은 아닙니다.
key = 0에서 시작합니다.- 글자마다
key = key × HASH_VAL + 글자 코드 + HASH_VAL로 섞습니다. - 마지막에
HASH_SIZE로 나눈 나머지를 key로 씁니다.
계산된 값은 매우 크기 때문에 HASH_SIZE로 나눈 나머지만 key로 씁니다. 그래서 key는 항상 0~999 사이에 들어옵니다. 대신 데이터가 많을수록 key가 겹치는(충돌하는) 문자열이 생길 수밖에 없습니다. 목표는 충돌을 최대한 줄이면서 빠르게 만드는 것입니다.
key는 배열 인덱스로 쓰므로 음수면 안 됩니다. 원문 Java 코드는 계산 중 정수가 넘쳐(오버플로) 음수가 될 수 있어서 if (key < 0) key = -key;로 양수로 바꿉니다. Python은 정수 크기에 한계가 없고, 아래 코드는 글자마다 나머지를 구해 숫자를 작게 유지하므로 항상 0 이상입니다.
같은 key 안에서 찾기
key를 얻었으면, 그 key 칸에 이 문자열이 들어온 적이 있는지 확인해야 합니다. 이제 모든 곳을 볼 필요 없이 이 key 칸만 확인하면 되므로 시간이 엄청나게 절약됩니다.
단, 데이터가 많으면 다른 문자열이 같은 key로 저장되어 있을 수 있습니다. 아래 그림에서는 John Smith와 Sandra Dee가 둘 다 152번 칸으로 가서(충돌), 같은 칸에 줄지어 저장됩니다. 그림은 연결 리스트로 잇고, 이 글의 구현은 칸마다 고정 크기 배열에 차례로 담는다는 점만 다릅니다.
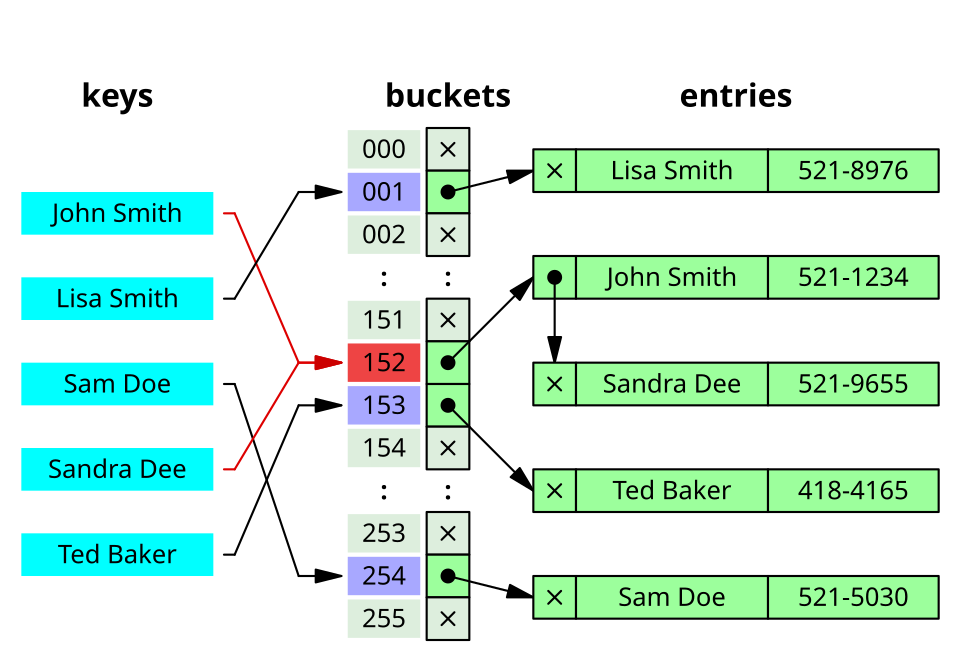
그림 출처: Wikimedia Commons (CC BY-SA 3.0, Jorge Stolfi)
그래서 key 칸 안을 돌면서 문자열이 정확히 일치하는지 비교합니다. 이 과정을 위해 배열 3개를 씁니다.
| 배열 | 크기 | 저장하는 것 |
|---|---|---|
s_data[key][i] | HASH_SIZE × HASH_LEN | 입력받은 문자열 자체 |
data[key][i] | HASH_SIZE × HASH_LEN | 그 문자열이 다시 들어온 횟수 |
length[key] | HASH_SIZE | key 칸마다 저장된 서로 다른 문자열 수 |
출력 조건은 두 가지입니다.
OK로 출력: 해당 key 칸의length가 0이면 무조건 처음 들어온 데이터입니다.length가 1 이상이어도 그 칸 안에서 같은 문자열을 못 찾았다면 역시 처음 들어온 데이터입니다.문자열+횟수로 출력:length가 1 이상이고 칸 안에서 같은 문자열을 찾았다면, 횟수를 1 늘리고문자열+횟수를 출력합니다.
리스트를 계속 늘려 가는 방식(Java의 ArrayList, Python의 append)으로 칸을 관리하면 그냥 계속 추가하면 되므로 구현이 간편합니다. 하지만 삼성 SW 역량테스트 B형처럼 라이브러리를 쓸 수 없는 경우에는 배열을 미리 선언해 두고 채워 나가야 합니다. 원문은 ArrayList보다 고정 크기 배열이 시간을 더 줄일 수 있으니 되도록 배열을 쓰자고 권합니다. 아래 Python 코드도 이 방식을 그대로 따라 크기가 정해진 리스트를 씁니다.
동작 과정
apple → banana → abc → abc 순서로 입력되고, apple과 abc의 key가 5로 같다고 가정해 보겠습니다. (충돌 상황)
| 순서 | 입력 | key | 확인 내용 | 저장 후 상태 | 출력 |
|---|---|---|---|---|---|
| 1 | apple | 5 | length[5] = 0 → 처음 | s_data[5][0] = apple, length[5] = 1 | OK |
| 2 | banana | 3 | length[3] = 0 → 처음 | s_data[3][0] = banana, length[3] = 1 | OK |
| 3 | abc | 5 | length[5] = 1이라 0번 칸 비교: apple ≠ abc → 처음 | s_data[5][1] = abc, length[5] = 2 | OK |
| 4 | abc | 5 | length[5] = 2라 0번, 1번 비교: 1번 칸 abc 일치 | data[5][1] = 1 | abc1 |
핵심은 3번과 4번입니다.
- 3번: key 5 칸에 누가 들어온 적은 있지만 apple뿐이므로 abc는 처음입니다. 현재
length[5]위치(1번 칸)에 abc를 넣고, 그다음length[5]를 2로 늘립니다. - 4번: key 5 칸을 2개만 비교하면 됩니다. 0번 칸은 apple, 1번 칸에서 abc를 찾았습니다.
data[5][1]을 1 늘리고 그 값 1을 돌려주면,abc뒤에 1을 붙여abc1을 출력합니다.
Python 코드
직접 구현한 해시 테이블
HASH_SIZE = 1000   # 칸(버킷) 개수
HASH_LEN = 400     # 칸 하나에 담을 수 있는 서로 다른 문자열 수
HASH_VAL = 17      # 곱하는 수 (소수)

data = [[0] * HASH_LEN for _ in range(HASH_SIZE)]       # 다시 들어온 횟수
length = [0] * HASH_SIZE                                # 칸마다 저장된 문자열 수
s_data = [[None] * HASH_LEN for _ in range(HASH_SIZE)]  # 실제 문자열


def get_hash_key(s):
    key = 0
    for ch in s:
        # 1. 글자마다 key를 섞고, 매번 나머지를 구해 숫자가 커지지 않게
        key = (key * HASH_VAL + ord(ch) + HASH_VAL) % HASH_SIZE
    return key  # 2. 항상 0 ~ HASH_SIZE-1 사이


def checking(key, s):
    for i in range(length[key]):       # 3. 같은 key 칸 안에서만 찾아보기
        if s_data[key][i] == s:
            data[key][i] += 1          # 4. 이미 있던 문자열: 횟수 +1 후 돌려주기
            return data[key][i]
    s_data[key][length[key]] = s       # 5. 처음 온 문자열: 현재 length 위치에 저장하고
    length[key] += 1                   #    그다음 개수 +1
    return -1                          #    처음이면 -1


def solve(lines):
    out = []
    for s in lines:
        cnt = checking(get_hash_key(s), s)
        out.append("OK" if cnt == -1 else s + str(cnt))  # 6. 출력 규칙
    return out


print("\n".join(solve(["abcd", "abc", "abcd", "abcd", "ab"])))
# 출력:
# OK
# OK
# abcd1
# abcd2
# OKord(ch)는 글자의 코드 번호입니다. 원문 전체 코드와 같은 식(key * 17 + 글자 + 17)이지만, 글자마다% HASH_SIZE를 해서 음수나 너무 큰 수가 생기지 않게 했습니다. 마지막에 한 번 나머지를 구하는 것과 결과가 같습니다.- 돌려주는 key는 칸 번호로 바로 쓸 수 있습니다.
- 해당 key 칸에 저장된 개수(
length[key])만큼만 비교합니다. 전체 10만 개가 아니라 보통 수십~백 개 정도입니다. - 같은 문자열을 찾으면 횟수를 늘리고 그 횟수를 돌려줍니다.
- 못 찾았으면 칸의 빈자리(
length[key]위치)에 저장한 뒤 개수를 늘립니다. 원문 Java의s_data[key][length[key]++] = str과 같은 순서입니다. -1이면OK, 아니면문자열+횟수를 출력합니다.
실제 제출할 때는 sys.stdin으로 N과 문자열들을 읽어 solve에 넘기면 됩니다. 한 칸에 서로 다른 문자열이 400개를 넘게 몰리면 IndexError가 나므로, 그럴 걱정이 있으면 HASH_LEN을 늘리거나 아래 dict 버전을 씁니다.
Python dict로 푼 버전
라이브러리를 쓸 수 있다면 Python의 dict가 위 과정을 내부에서 대신 해 줍니다.
def solve_dict(lines):
    seen = {}                        # 1. 문자열 → 다시 들어온 횟수
    out = []
    for s in lines:
        if s in seen:                # 2. 평균 O(1)로 들어온 적 있는지 확인
            seen[s] += 1
            out.append(s + str(seen[s]))
        else:
            seen[s] = 0              # 3. 처음이면 0으로 등록
            out.append("OK")
    return out


print(solve_dict(["abcd", "abc", "abcd", "abcd", "ab"]))
# 출력: ['OK', 'OK', 'abcd1', 'abcd2', 'OK']dict의 key는 문자열, 값은 다시 들어온 횟수입니다.in검사는 내부에서 해시로 칸을 찾아 비교하므로 평균 O(1)입니다.- 처음 들어온 문자열은 횟수 0으로 등록하고
OK를 출력합니다.
시간복잡도와 공간복잡도
| 경우 | 찾기/넣기 1번 | N개 처리 | 이유 |
|---|---|---|---|
| 최선 | O(1) | O(N) | key 칸이 비어 있거나 첫 칸에서 바로 찾음 |
| 평균 | O(1) | O(N) | 문자열이 칸에 고르게 퍼지면 칸당 개수가 적음 |
| 최악 | O(N) | O(N²) | 모든 문자열이 한 칸에 몰리면 결국 전부 비교 |
- 여기서 O(1)은 "칸 안에서 비교하는 횟수"가 상수라는 뜻입니다. key를 계산하고 문자열을 비교하는 데는 문자열 길이 L만큼 시간이 들어, 엄밀히는 한 번에 O(L)입니다.
- 공간복잡도: 직접 구현 버전은 미리 잡은 배열 크기 O(HASH_SIZE × HASH_LEN),
dict버전은 저장한 문자열 수만큼 O(N). - 브루트 포스 O(N²)(약 100억 번)가 해시로 평균 O(N)(약 10만 번)이 되는 것이 핵심입니다. 복잡도 표기는 시간 복잡도 글을 참고하세요.
정리
| 개념 | 비전공자 버전 요약 |
|---|---|
| 해시 테이블 | 이름으로 사물함 번호를 계산해 그 칸에만 넣고 찾기 |
| 해시 함수 | 문자열을 정해진 범위의 칸 번호로 바꾸는 계산법 |
| 충돌 | 다른 문자열인데 같은 칸 번호가 나오는 것. 칸 안에서 한 번 더 비교해 구분 |
| 소수 HASH_VAL | 칸 번호가 한쪽에 몰리지 않고 고르게 퍼지게 하는 요령 |