
이분 탐색 (Binary Search)
이분 탐색은 정렬된 배열에서 탐색 범위를 절반씩 줄여 가며 원하는 값을 찾는 방법입니다.
한눈에 보기
탐색 범위를 두 부분으로 나누면서 찾는 방식입니다. 처음부터 끝까지 하나씩 확인하는 전체 탐색보다 훨씬 빠릅니다.
비유하면 사전에서 단어 찾기와 같습니다. "ㅎ"으로 시작하는 단어를 찾을 때 첫 장부터 넘기지 않습니다. 대충 가운데를 펼쳐 보고, 찾는 단어가 더 뒤에 있으면 뒤쪽 절반만, 앞에 있으면 앞쪽 절반만 다시 봅니다.
| 방법 | 시간복잡도 |
|---|---|
| 전체 탐색 | O(N) |
| 이분 탐색 | O(log N) |
단, 이분 탐색은 배열이 이미 정렬되어 있어야 쓸 수 있습니다. "가운데 값보다 크면 오른쪽에 있다"는 판단이 정렬되어 있을 때만 맞기 때문입니다.
동작 과정
- 우선 배열을 정렬합니다. (이미 정렬되어 있으면 생략)
- 범위의 왼쪽 끝
left와 오른쪽 끝right로 가운데 위치mid를 정합니다. mid위치의 값과 찾으려는 값을 비교합니다.- 찾으려는 값이
mid값보다 크면left = mid + 1, 작으면right = mid - 1로 범위를 줄입니다. - 같으면 찾은 것이고,
left > right가 되면(범위가 비면) 값이 없는 것입니다.
예시: [1, 3, 5, 7, 9, 11, 13]에서 11 찾기
| 단계 | left | right | mid | arr[mid] | 설명 |
|---|---|---|---|---|---|
| 1 | 0 | 6 | 3 | 7 | 7 < 11 → 오른쪽 절반으로 (left = 4) |
| 2 | 4 | 6 | 5 | 11 | 찾음! 인덱스 5 반환 |
예시: 같은 배열에서 4 찾기 (없는 값)
| 단계 | left | right | mid | arr[mid] | 설명 |
|---|---|---|---|---|---|
| 1 | 0 | 6 | 3 | 7 | 7 > 4 → 왼쪽 절반으로 (right = 2) |
| 2 | 0 | 2 | 1 | 3 | 3 < 4 → 오른쪽 절반으로 (left = 2) |
| 3 | 2 | 2 | 2 | 5 | 5 > 4 → 왼쪽 절반으로 (right = 1) |
| 4 | 2 | 1 | - | - | left > right → 범위가 비었으니 값이 없음 |
원소 7개인데 최대 3번만 비교하면 결론이 납니다.
아래 그림은 원소 17개짜리 정렬된 배열에서 7을 찾는 모습입니다. 가운데 14와 비교해 왼쪽 절반으로, 다시 가운데 6과 비교해 오른쪽으로, 8과 비교해 왼쪽으로 좁혀 네 번 만에 7을 찾습니다.
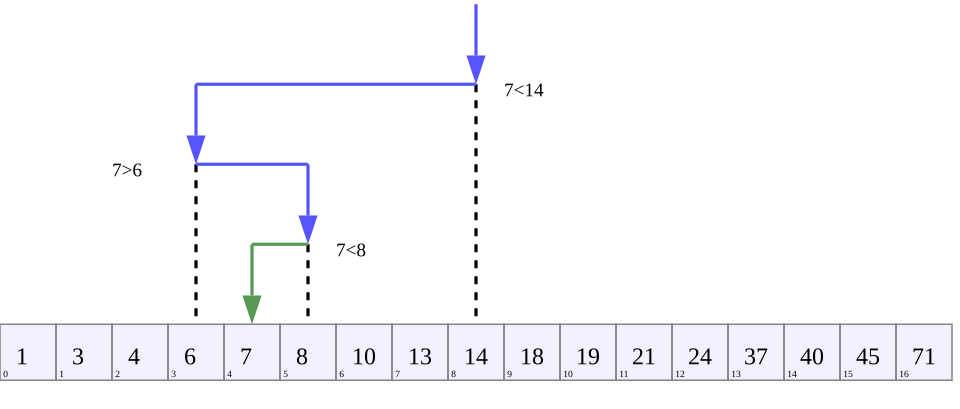
그림 출처: Wikimedia Commons (CC BY-SA 4.0, AlwaysAngry)
Python 코드
python
def binary_search(arr, target):
    """정렬된 arr에서 target의 인덱스를 찾는 이분 탐색"""
    # 1. 탐색 범위의 양 끝
    left, right = 0, len(arr) - 1

    # 2. 범위가 남아 있는 동안 반복
    while left <= right:
        mid = (left + right) // 2      # 3. 가운데 위치
        if arr[mid] == target:         # 4. 찾음
            return mid
        elif arr[mid] < target:        # 5. 찾는 값이 더 큼 → 오른쪽 절반
            left = mid + 1
        else:                          # 6. 찾는 값이 더 작음 → 왼쪽 절반
            right = mid - 1

    # 7. 범위가 비었는데 못 찾음
    raise ValueError("타겟 존재하지 않음")


arr = [9, 1, 13, 5, 3, 11, 7]
arr.sort()                             # 이분 탐색 전에 반드시 정렬
print(arr)                             # 출력: [1, 3, 5, 7, 9, 11, 13]
print(binary_search(arr, 11)) # 출력: 5left는 범위의 첫 인덱스,right는 마지막 인덱스입니다.left <= right인 동안은 아직 확인할 칸이 남아 있다는 뜻입니다.- 가운데 인덱스를 구합니다.
//는 몫만 남기는 나눗셈입니다. - 가운데 값이 찾는 값이면 바로 인덱스를 돌려줍니다.
- 가운데 값이 더 작으면 답은 오른쪽에 있으므로 왼쪽 끝을
mid + 1로 옮깁니다. - 가운데 값이 더 크면 답은 왼쪽에 있으므로 오른쪽 끝을
mid - 1로 옮깁니다. - 범위가 비어 버리면 배열에 값이 없으므로 오류를 냅니다.
주의할 점:
- 정렬은 함수 밖에서 한 번만 합니다. 원문처럼 함수 안에서 매번 정렬하면, 돌려주는 인덱스가 원래 배열이 아니라 정렬된 배열 기준이 되고, 호출할 때마다 정렬 비용 O(N log N)이 들어 이분 탐색의 장점이 사라집니다.
- Java, C처럼 정수 크기에 한계가 있는 언어에서는
(left + right) / 2가 넘칠(오버플로) 수 있어left + (right - left) / 2로 쓰는 경우가 많습니다. Python 정수는 한계가 없어 괜찮습니다. - Python에는 이분 탐색 표준 모듈
bisect도 있습니다.bisect.bisect_left(arr, x)는x가 들어갈 자리를 O(log N)에 알려 줍니다.
시간복잡도와 공간복잡도
| 경우 | 시간복잡도 | 이유 |
|---|---|---|
| 최선 | O(1) | 첫 가운데 값이 바로 답인 경우 |
| 평균 | O(log N) | 한 번 비교할 때마다 범위가 절반으로 줄어듦 |
| 최악 | O(log N) | 범위가 1칸이 될 때까지 절반씩 줄여도 약 log₂N번 |
- 공간복잡도: 추가 메모리 O(1) (
left,right,mid변수 몇 개뿐) - 정렬되지 않은 배열이라면 정렬 비용 O(N log N)이 먼저 듭니다. 그래서 한 번 정렬해 두고 여러 번 찾을 때 가장 효과적입니다.
원소가 100만 개여도 약 20번이면 찾습니다(2²⁰ ≈ 100만). 복잡도 표기가 낯설다면 시간 복잡도 글을 먼저 보면 좋습니다.
활용 예
- 정렬된 목록에서 특정 값이 있는지, 몇 번째인지 찾기
- 값이 들어갈 위치 찾기 (
bisect), 정렬 상태를 유지하며 삽입하기 - "조건을 만족하는 가장 작은/큰 값"을 찾는 문제 (답의 범위를 절반씩 줄여 가는 방식, 흔히 "매개변수 탐색")
- 최장 증가 수열(LIS)을 O(N log N)에 구할 때
정리
| 개념 | 비전공자 버전 요약 |
|---|---|
| 이분 탐색 | 사전 찾듯 가운데를 펼쳐 보고 절반씩 버려 가며 찾기 |
| 전제 조건 | 배열이 반드시 정렬되어 있어야 함 |
| 속도 | 100만 개 중에서도 약 20번 비교로 찾음 (O(log N)) |