
페이지 교체 알고리즘 (FIFO · OPT · LRU · LFU)
페이지 교체 알고리즘은 메모리가 꽉 찬 상태에서 새 페이지를 올려야 할 때, 이미 올라와 있는 페이지 중 무엇을 내보낼지 정하는 규칙입니다. 잘 고를수록 페이지 부재가 줄어 프로그램이 빨라집니다.
한눈에 보기
- 비유: 책상(메모리)에 책을 3권만 펼쳐 둘 수 있는데, 새 책을 봐야 합니다. 한 권은 서고(디스크)로 돌려보내야 하죠. "가장 먼저 꺼낸 책", "앞으로 가장 늦게 볼 책", "가장 오래 안 본 책", "가장 적게 본 책" 중 무엇을 돌려보낼지가 바로 각 알고리즘의 차이입니다.
- 이때 내보내는 페이지를 희생 페이지(victim page) 라고 합니다.
- 페이징과 가상 메모리, 페이지 교체가 일어나는 순서는 메모리 관리에 정리해 두었습니다.
왜 페이지 교체가 필요한가
가상 메모리는 요구 페이징(Demand Paging) 으로, 당장 필요한 페이지만 메모리에 올리고 쓰지 않는 부분은 디스크에 그대로 둡니다.
하지만 필요한 페이지만 올려도 메모리는 결국 가득 찹니다. 게다가 한 번 올라온 페이지는 다 쓴 뒤에도 자리만 차지하고 있을 수 있습니다. 그래서 메모리가 가득 차면, 안 쓰는 페이지를 내보내고(out) 그 자리에 지금 필요한 페이지를 들여와야(in) 합니다.
이왕이면 수정되지 않은 페이지를 내보내는 게 좋습니다. 수정된 페이지는 내보낼 때 바뀐 내용을 디스크에 다시 써야 해서 시간이 더 걸리기 때문입니다. (이것을 확인하는 변경 비트는 메모리 관리에서 설명합니다.)
페이지 참조열 (Page Reference String)
CPU는 논리 주소로 메모리를 요청하는데, 메모리는 페이지 단위로 올라옵니다. 그래서 같은 페이지 안의 주소를 연달아 요청하면 첫 번째만 의미가 있고, 나머지는 그 페이지가 이미 올라와 있으니 페이지 부재가 날 수 없습니다.
그래서 알고리즘을 비교할 때는 주소 대신 페이지 번호만 순서대로 적고, 바로 앞과 같은 번호가 연속되면 하나로 줄여서 씁니다. 이것을 페이지 참조열이라고 합니다.
요청한 주소 (페이지 크기 100) : 0100 0432 0101 0612 0102 0103 0104 0611
페이지 번호                    :   1    4    1    6    1    1    1    6
연속 중복을 줄인 참조열        :   1    4    1    6    1              6
이 글의 모든 예제는 아래 참조열과 프레임 3개로 비교합니다. 운영체제 교과서에서 자주 쓰는 예시입니다.
7 0 1 2 0 3 0 4 2 3 0 3 2 1 2 0 1 7 0 1시뮬레이터 코드
아래 표들은 손으로 그린 게 아니라, 이 Python 시뮬레이터를 실제로 실행해서 만든 결과입니다.
def simulate(refs, n_frames, policy):
    frames = []        # 지금 메모리에 올라와 있는 페이지
    loaded_at = {}     # 페이지가 메모리에 올라온 시점 (FIFO용)
    last_used = {}     # 마지막으로 쓴 시점 (LRU용)
    use_count = {}     # 지금까지 쓴 횟수 (LFU용)
    faults = 0
    log = []

    for t, page in enumerate(refs):
        victim = None
        if page in frames:
            result = "적중"
        else:
            result = "부재"
            faults += 1
            if len(frames) == n_frames:  # 빈 자리가 없으면 하나를 내보냄
                if policy == "FIFO":     # 가장 먼저 들어온 페이지
                    victim = min(frames, key=lambda p: loaded_at[p])
                elif policy == "OPT":    # 앞으로 가장 늦게 쓰일 페이지
                    def next_use(p):
                        rest = refs[t + 1:]
                        return rest.index(p) if p in rest else float("inf")
                    victim = max(frames, key=next_use)
                elif policy == "LRU":    # 가장 오래전에 쓴 페이지
                    victim = min(frames, key=lambda p: last_used[p])
                elif policy == "LFU":    # 가장 적게 쓴 페이지 (같으면 먼저 들어온 것)
                    victim = min(frames, key=lambda p: (use_count[p], loaded_at[p]))
                elif policy == "MFU":    # 가장 많이 쓴 페이지 (같으면 먼저 들어온 것)
                    victim = min(frames, key=lambda p: (-use_count[p], loaded_at[p]))
                frames[frames.index(victim)] = page
                del use_count[victim]
            else:
                frames.append(page)
            loaded_at[page] = t
            use_count[page] = 0
        last_used[page] = t
        use_count[page] += 1
        log.append((t + 1, page, list(frames), result, victim))
    return faults, log

refs = [7, 0, 1, 2, 0, 3, 0, 4, 2, 3, 0, 3, 2, 1, 2, 0, 1, 7, 0, 1]

if __name__ == "__main__":
    for policy in ["FIFO", "OPT", "LRU", "LFU", "MFU"]:
        faults, log = simulate(refs, 3, policy)
print(f"{policy}: 페이지 부재 {faults}번")FIFO: 페이지 부재 15번
OPT: 페이지 부재 9번
LRU: 페이지 부재 12번
LFU: 페이지 부재 13번
MFU: 페이지 부재 15번표의 "프레임" 칸은 프레임 3칸에 들어 있는 페이지를 자리 순서대로 적은 것이고, -는 빈칸입니다. 처음 세 번은 메모리가 비어 있어서 어떤 알고리즘이든 무조건 부재가 납니다.
1. FIFO (First In First Out)
메모리에 가장 먼저 올라온 페이지를 가장 먼저 내보냅니다. 줄 서기와 같습니다.
- 가장 간단해서 구현이 쉽습니다.
- 초기화 코드에 잘 맞습니다. 초기화 코드는 프로세스가 처음 실행될 때 한 번만 필요하고 그 뒤로는 쓰이지 않습니다. 처음엔 반드시 필요하니 먼저 올라오고, FIFO는 그렇게 먼저 올라온 페이지를 먼저 내보내므로 초기화가 끝난 뒤 자연스럽게 정리됩니다.
- 하지만 "먼저 왔다"는 것과 "앞으로 안 쓴다"는 것은 상관이 없습니다. 처음 올라왔지만 계속 쓰는 페이지(예: 자주 부르는 함수)도 순서가 되면 내보내서, 곧바로 다시 부재가 납니다.
| 순서 | 요청 | 프레임 | 결과 | 내보낸 페이지 |
|---|---|---|---|---|
| 1 | 7 | 7 - - | 부재 | |
| 2 | 0 | 7 0 - | 부재 | |
| 3 | 1 | 7 0 1 | 부재 | |
| 4 | 2 | 2 0 1 | 부재 | 7 |
| 5 | 0 | 2 0 1 | 적중 | |
| 6 | 3 | 2 3 1 | 부재 | 0 |
| 7 | 0 | 2 3 0 | 부재 | 1 |
| 8 | 4 | 4 3 0 | 부재 | 2 |
| 9 | 2 | 4 2 0 | 부재 | 3 |
| 10 | 3 | 4 2 3 | 부재 | 0 |
| 11 | 0 | 0 2 3 | 부재 | 4 |
| 12 | 3 | 0 2 3 | 적중 | |
| 13 | 2 | 0 2 3 | 적중 | |
| 14 | 1 | 0 1 3 | 부재 | 2 |
| 15 | 2 | 0 1 2 | 부재 | 3 |
| 16 | 0 | 0 1 2 | 적중 | |
| 17 | 1 | 0 1 2 | 적중 | |
| 18 | 7 | 7 1 2 | 부재 | 0 |
| 19 | 0 | 7 0 2 | 부재 | 1 |
| 20 | 1 | 7 0 1 | 부재 | 2 |
페이지 부재 15번. 6번 단계에서 바로 앞(5번 단계)에 쓴 0번을 내보냈다가 바로 다음 7번 단계에서 다시 불러오는 식의 낭비가 여러 번 보입니다.
같은 과정을 그림으로 보면 다음과 같습니다. 파란 칸이 새로 들어온 페이지이고, 적중해서 바뀐 것이 없는 단계는 그림에서 생략했습니다.
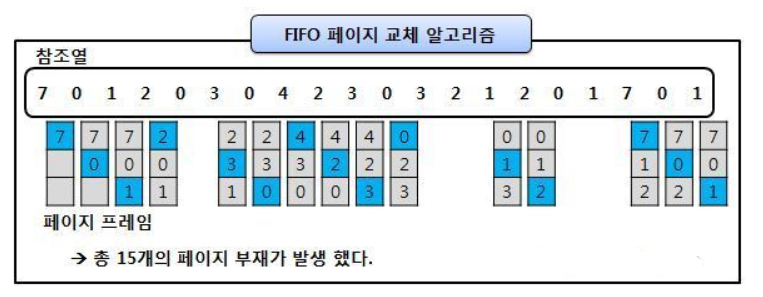
그림 출처: gyoogle 기술 면접 정리, Page Replacement Algorithm
벨레이디의 모순 (Belady's Anomaly)
상식적으로는 프레임을 늘리면 페이지 부재가 줄어야 합니다. 그런데 FIFO는 프레임을 늘렸는데 오히려 부재가 늘어나는 경우가 있습니다.
위 시뮬레이터를 paging.py로 저장해 두고, 다른 참조열로 프레임 3개와 4개를 비교해 봤습니다.
from paging import simulate
refs = [1, 2, 3, 4, 1, 2, 5, 1, 2, 3, 4, 5]
for n in (3, 4):
print(f"FIFO, 프레임 {n}개: 페이지 부재 {simulate(refs, n, 'FIFO')[0]}번")FIFO, 프레임 3개: 페이지 부재 9번
FIFO, 프레임 4개: 페이지 부재 10번OPT와 LRU에서는 이런 일이 일어나지 않습니다.
2. OPT (Optimal, 최적 교체)
앞으로 가장 오랫동안 쓰이지 않을 페이지를 내보냅니다. 앞으로 다시 안 쓰이는 페이지가 있으면 그게 1순위입니다.
- 이론상 페이지 부재가 가장 적은 알고리즘입니다. FIFO보다 부재를 크게 줄일 수 있습니다.
- 하지만 실제로는 쓸 수 없습니다. 운영체제는 프로그램이 앞으로 어떤 페이지를 요청할지 미리 알 수 없기 때문입니다.
- 그래서 OPT는 다른 알고리즘이 얼마나 좋은지 재는 기준점으로 씁니다. "LRU가 OPT에 얼마나 가까운가"처럼 비교합니다.
| 순서 | 요청 | 프레임 | 결과 | 내보낸 페이지 |
|---|---|---|---|---|
| 1 | 7 | 7 - - | 부재 | |
| 2 | 0 | 7 0 - | 부재 | |
| 3 | 1 | 7 0 1 | 부재 | |
| 4 | 2 | 2 0 1 | 부재 | 7 |
| 5 | 0 | 2 0 1 | 적중 | |
| 6 | 3 | 2 0 3 | 부재 | 1 |
| 7 | 0 | 2 0 3 | 적중 | |
| 8 | 4 | 2 4 3 | 부재 | 0 |
| 9 | 2 | 2 4 3 | 적중 | |
| 10 | 3 | 2 4 3 | 적중 | |
| 11 | 0 | 2 0 3 | 부재 | 4 |
| 12 | 3 | 2 0 3 | 적중 | |
| 13 | 2 | 2 0 3 | 적중 | |
| 14 | 1 | 2 0 1 | 부재 | 3 |
| 15 | 2 | 2 0 1 | 적중 | |
| 16 | 0 | 2 0 1 | 적중 | |
| 17 | 1 | 2 0 1 | 적중 | |
| 18 | 7 | 7 0 1 | 부재 | 2 |
| 19 | 0 | 7 0 1 | 적중 | |
| 20 | 1 | 7 0 1 | 적중 |
페이지 부재 9번. 같은 참조열과 프레임 수로는 이보다 적게 할 수 없습니다. 예를 들어 6번 단계에서 3번 페이지가 들어올 때, 2, 0, 1 중 다음에 가장 늦게 쓰이는 1번(14번 단계)을 내보냈습니다.
그림으로 보면 부재가 난 단계가 FIFO보다 눈에 띄게 적습니다.
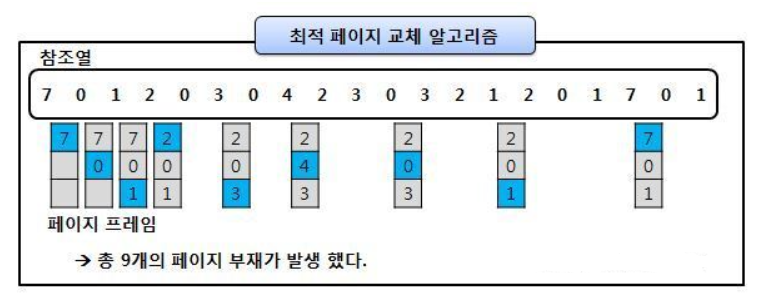
그림 출처: gyoogle 기술 면접 정리, Page Replacement Algorithm
3. LRU (Least Recently Used)
가장 오랫동안 쓰이지 않은 페이지를 내보냅니다. "최근에 안 쓴 것은 앞으로도 안 쓸 것"이라는 생각에서 나왔습니다.
- OPT는 미래를 보지만, LRU는 과거를 보고 판단하므로 실제로 쓸 수 있습니다.
- 실제 프로그램은 최근에 쓴 데이터를 곧 다시 쓰는 경향(시간 지역성)이 강해서, 최근에 안 쓴 페이지는 앞으로도 안 쓸 가능성이 높습니다.
- OPT보다는 부재가 더 날 수 있지만, 실제로 쓸 수 있는 알고리즘 중에서는 가장 좋은 방법 중 하나입니다.
| 순서 | 요청 | 프레임 | 결과 | 내보낸 페이지 |
|---|---|---|---|---|
| 1 | 7 | 7 - - | 부재 | |
| 2 | 0 | 7 0 - | 부재 | |
| 3 | 1 | 7 0 1 | 부재 | |
| 4 | 2 | 2 0 1 | 부재 | 7 |
| 5 | 0 | 2 0 1 | 적중 | |
| 6 | 3 | 2 0 3 | 부재 | 1 |
| 7 | 0 | 2 0 3 | 적중 | |
| 8 | 4 | 4 0 3 | 부재 | 2 |
| 9 | 2 | 4 0 2 | 부재 | 3 |
| 10 | 3 | 4 3 2 | 부재 | 0 |
| 11 | 0 | 0 3 2 | 부재 | 4 |
| 12 | 3 | 0 3 2 | 적중 | |
| 13 | 2 | 0 3 2 | 적중 | |
| 14 | 1 | 1 3 2 | 부재 | 0 |
| 15 | 2 | 1 3 2 | 적중 | |
| 16 | 0 | 1 0 2 | 부재 | 3 |
| 17 | 1 | 1 0 2 | 적중 | |
| 18 | 7 | 1 0 7 | 부재 | 2 |
| 19 | 0 | 1 0 7 | 적중 | |
| 20 | 1 | 1 0 7 | 적중 |
페이지 부재 12번. FIFO(15번)보다 3번 적고, 최적값(9번)에 꽤 가깝습니다.
그림으로 보면 다음과 같습니다. 그림의 각 칸은 위 표에서 부재가 난 단계와 하나씩 맞습니다.
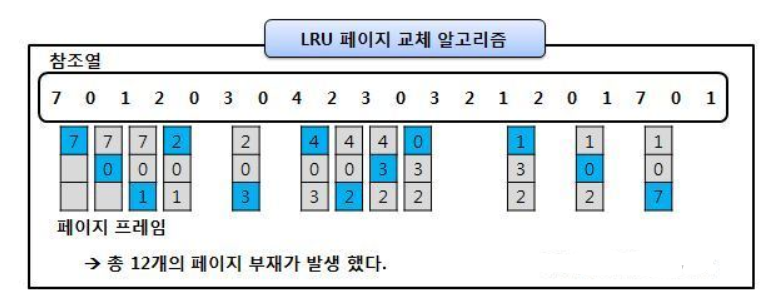
그림 출처: gyoogle 기술 면접 정리, Page Replacement Algorithm
LRU는 페이지 교체뿐 아니라 캐시에서도 아주 많이 씁니다. Redis 같은 캐시에서 LRU를 어떻게 구현하는지는 LRU와 TTL에서 볼 수 있습니다.
4. LFU (Least Frequently Used)
지금까지 가장 적게 쓰인 페이지를 내보냅니다. 많이 쓴 페이지는 중요하다고 보고 남겨 둡니다. 쓴 횟수가 같으면 먼저 들어온 페이지를 내보냈습니다. (이 시뮬레이터는 페이지가 메모리에서 나가면 횟수를 0으로 초기화합니다.)
| 순서 | 요청 | 프레임 | 결과 | 내보낸 페이지 |
|---|---|---|---|---|
| 1 | 7 | 7 - - | 부재 | |
| 2 | 0 | 7 0 - | 부재 | |
| 3 | 1 | 7 0 1 | 부재 | |
| 4 | 2 | 2 0 1 | 부재 | 7 |
| 5 | 0 | 2 0 1 | 적중 | |
| 6 | 3 | 2 0 3 | 부재 | 1 |
| 7 | 0 | 2 0 3 | 적중 | |
| 8 | 4 | 4 0 3 | 부재 | 2 |
| 9 | 2 | 4 0 2 | 부재 | 3 |
| 10 | 3 | 3 0 2 | 부재 | 4 |
| 11 | 0 | 3 0 2 | 적중 | |
| 12 | 3 | 3 0 2 | 적중 | |
| 13 | 2 | 3 0 2 | 적중 | |
| 14 | 1 | 3 0 1 | 부재 | 2 |
| 15 | 2 | 3 0 2 | 부재 | 1 |
| 16 | 0 | 3 0 2 | 적중 | |
| 17 | 1 | 3 0 1 | 부재 | 2 |
| 18 | 7 | 3 0 7 | 부재 | 1 |
| 19 | 0 | 3 0 7 | 적중 | |
| 20 | 1 | 3 0 1 | 부재 | 7 |
페이지 부재 13번. LFU의 약점도 보입니다. 3번 페이지는 10번, 12번 단계에서 쓰여 횟수가 2가 된 뒤, 13번 단계부터는 한 번도 안 쓰이는데도 끝까지 자리를 차지합니다. 그 때문에 후반에 1, 2, 7이 서로 계속 밀어내며 부재가 이어집니다. 예전에 많이 썼던 페이지가 버티는 문제입니다.
5. 그 밖의 알고리즘
MFU (Most Frequently Used)
LFU와 반대로 가장 많이 쓰인 페이지를 내보냅니다. "많이 쓴 페이지는 이미 할 일을 다 했고, 적게 쓴 페이지는 이제 막 올라와서 앞으로 쓰일 것"이라는 생각입니다. 위 참조열에서는 부재 15번으로 FIFO와 같았고, 실제로는 잘 쓰이지 않습니다.
클록 (Clock, 2차 기회)
LRU는 좋지만, 페이지를 쓸 때마다 "언제 썼는지"를 정확히 기록하려면 하드웨어 부담이 큽니다. 그래서 실제 운영체제는 LRU를 비슷하게 흉내 내는 클록 알고리즘을 많이 씁니다.
- 페이지마다 참조 비트 하나를 둡니다. 페이지를 쓰면 하드웨어가 1로 바꿉니다.
- 페이지들을 시계 판처럼 동그랗게 놓고, 바늘이 돌면서 내보낼 페이지를 찾습니다.
- 바늘이 가리킨 페이지의 참조 비트가 1이면 "최근에 썼구나" 하고 한 번 봐주면서 0으로 바꾸고 다음으로 넘어갑니다. 0이면 그 페이지를 내보냅니다.
          ┌── 페이지 A (1) ──┐
          │                  │
   페이지 D (0)         페이지 B (1)     바늘이 B를 가리킴
          │                  │          → B는 1이라 0으로 바꾸고 통과
          └── 페이지 C (0) ──┘          → C는 0이라 C를 내보냄
같은 참조열을 클록으로 돌려 보니 페이지 부재 14번이었습니다(새로 들어온 페이지의 참조 비트를 1로 시작하는 방식). 참조 비트와 변경 비트를 함께 보는 변형은 NUR(Not Used Recently) 이라고 부릅니다.
결과 비교
| 알고리즘 | 내보내는 페이지 | 페이지 부재 (위 참조열, 프레임 3개) | 실제 사용 |
|---|---|---|---|
| OPT | 앞으로 가장 늦게 쓰일 것 | 9번 | 불가능 (미래를 알아야 함), 비교 기준 |
| LRU | 가장 오래 안 쓴 것 | 12번 | 많이 씀 (주로 근사 방식으로) |
| LFU | 가장 적게 쓴 것 | 13번 | 일부 캐시에서 씀 |
| 클록 | 참조 비트가 0인 것 | 14번 | 실제 운영체제에서 많이 씀 |
| FIFO | 가장 먼저 들어온 것 | 15번 | 간단하지만 성능이 낮음 |
| MFU | 가장 많이 쓴 것 | 15번 | 거의 안 씀 |
교체 범위: 전역 교체와 지역 교체
다중 프로그래밍에서는 메모리에 여러 프로세스의 페이지가 함께 올라와 있습니다. 그래서 victim을 고를 때 어디까지를 후보로 볼지도 정해야 합니다.
| 방식 | 후보 | 장점 | 단점 |
|---|---|---|---|
| 전역 교체 (Global) | 메모리에 있는 모든 프로세스의 페이지 | 메모리가 필요한 프로세스가 더 많이 가져갈 수 있어 전체 처리량이 높음 | 다른 프로세스 때문에 내 페이지가 밀려나 성능이 들쭉날쭉할 수 있음 |
| 지역 교체 (Local) | 자기 프로세스의 페이지만 | 다른 프로세스의 영향을 받지 않아 성능이 예측 가능 | 한 프로세스에 프레임이 남아도 다른 프로세스가 못 씀 |
실제로는 전역 교체가 더 효율적이라서 리눅스 같은 일반 운영체제는 주로 전역 교체를 씁니다. 지역 교체는 프로세스마다 받은 프레임 수가 고정되어서, 어떤 프로세스는 프레임이 남고 어떤 프로세스는 모자라도 서로 나눠 쓸 수 없기 때문입니다.
스래싱 (Thrashing)
프로세스들이 쓰는 페이지에 비해 프레임이 너무 적으면, 페이지를 내보내자마자 다시 필요해지는 일이 끝없이 반복됩니다. CPU는 디스크를 기다리느라 거의 놀고, 시스템은 페이지 교체만 하다가 아무 일도 못 하게 됩니다. 이것을 스래싱이라고 합니다.
- 비유: 책상이 너무 좁아서 책을 펼치자마자 다른 책 때문에 다시 서고에 갖다 놓고, 또 꺼내 오는 일만 반복하는 상황입니다.
- 해결: 동시에 실행하는 프로세스 수를 줄이거나, 각 프로세스가 최근에 자주 쓰는 페이지 묶음(워킹 셋)이 다 들어갈 만큼 프레임을 보장해 줍니다. 결국에는 메모리를 늘리는 것이 가장 확실합니다.
정리
| 개념 | 비전공자 버전 요약 |
|---|---|
| 페이지 교체 | 책상이 꽉 찼을 때 어떤 책을 서고로 돌려보낼지 정하기 |
| 희생 페이지 | 메모리에서 내보내기로 고른 페이지 |
| 페이지 참조열 | 요청한 페이지 번호를 순서대로 적은 것 (연속 중복은 하나로) |
| FIFO | 먼저 온 페이지부터 내보냄. 간단하지만 자주 쓰는 것도 내보냄 |
| 벨레이디의 모순 | FIFO는 프레임을 늘려도 부재가 늘 수 있음 |
| OPT | 앞으로 가장 늦게 쓸 페이지를 내보냄. 최고지만 미래를 알 수 없어 실제로는 못 씀 |
| LRU | 가장 오래 안 쓴 페이지를 내보냄. 실제로 쓰는 것 중 가장 좋은 편 |
| LFU | 가장 적게 쓴 페이지를 내보냄. 예전에 많이 쓴 페이지가 버티는 문제 |
| 클록 | 참조 비트로 한 번 봐주는 LRU 흉내. 실제 운영체제가 많이 씀 |
| 전역 / 지역 교체 | 모든 프로세스에서 고를지, 내 프로세스에서만 고를지 |
| 스래싱 | 프레임이 모자라 페이지 교체만 하다가 아무 일도 못 하는 상태 |