
메모리 관리 (MMU · 단편화 · 페이징 · 세그멘테이션 · 가상 메모리)
메모리 관리는 한정된 메인 메모리를 여러 프로세스가 안전하고 효율적으로 나눠 쓰게 하는 운영체제의 일입니다. 누구에게 어느 공간을 줄지, 남의 공간을 침범하지 않게 어떻게 막을지, 메모리가 모자라면 어떻게 할지를 다룹니다.
한눈에 보기
- 비유: 메인 메모리는 도서관 열람실 책상, 하드디스크는 서고입니다. 책상은 빠르게 볼 수 있지만 자리가 적고, 서고는 넓지만 가서 가져오는 데 오래 걸립니다.
- 운영체제는 열람실 관리자입니다. 사람(프로세스)마다 책상을 나눠 주고, 남의 책상을 건드리지 못하게 하고, 책상이 모자라면 당장 안 보는 책을 서고로 돌려보내 자리를 만듭니다.
- 하나의 프로세스 안에서 메모리가 Stack, Heap 같은 영역으로 어떻게 나뉘는지는 메모리 구조에서 다뤘습니다. 이 글은 그보다 한 단계 위에서, 운영체제가 여러 프로세스에게 메모리를 어떻게 나눠 주는지를 봅니다.
메인 메모리 (Main Memory)
메인 메모리(RAM)는 CPU가 직접 접근할 수 있는 기억 장치입니다. 프로그램을 실행하려면 먼저 메모리에 올려야 합니다.
- 메모리는 주소가 붙은 바이트들이 한 줄로 늘어선 구조입니다.
- CPU는 레지스터(프로그램 카운터)가 가리키는 주소로 가서 다음에 실행할 명령어를 가져옵니다.
- 명령어를 실행하는 데 필요한 데이터가 메모리에 없으면, 먼저 디스크에서 메모리로 가져와야 합니다. 이때 하드웨어인 MMU가 "그 데이터가 메모리에 없다"는 사실을 알아채고 알리면(페이지 부재), 운영체제가 디스크에서 데이터를 가져옵니다.
논리 주소와 물리 주소
| 구분 | 뜻 | 누가 보나 |
|---|---|---|
| 논리 주소 (가상 주소) | 프로그램이 보는 주소. 각 프로세스는 자기 메모리가 0번지부터 시작한다고 생각함 | 프로그램, CPU |
| 물리 주소 | 실제 RAM 칩 위의 주소 | 메모리 하드웨어 |
프로그램이 "100번지를 읽어 줘"라고 하면, 그 100번지는 논리 주소입니다. 실제로는 RAM의 20,580번지일 수도 있습니다. 이 번역을 해 주는 장치가 MMU입니다.
MMU (Memory Management Unit, 메모리 관리 장치)
MMU는 논리 주소를 물리 주소로 바꿔 주는 하드웨어입니다. 메모리 보호나 캐시 관리처럼 CPU가 메모리에 접근하는 일을 전반적으로 관리합니다.
메모리 공간은 한정되어 있기 때문에, 사용자에게 실제보다 더 많은 메모리를 주는 것처럼 보이게 하려고 가상 주소라는 개념이 생겼습니다. 가상 주소는 프로그램 입장에서 보이는 주소 공간입니다. 가상 주소로 실제 데이터가 있는 곳을 찾아가려면 아주 빠른 주소 변환이 필요한데, 이걸 MMU가 맡습니다.
MMU가 있어서 좋은 점은 이렇습니다.
- MMU가 없으면 프로그램이 물리 주소에 직접 접근해야 해서, 프로그램끼리 주소가 겹치지 않게 일일이 신경 써야 합니다.
- 사용자가 기억 장소를 직접 하나하나 할당해야 하는 불편이 사라집니다.
- 프로세스의 크기가 실제 메모리 용량보다 커도 실행할 수 있게 해 줍니다. (아래 가상 메모리에서 설명합니다.)
또 CPU가 매번 느린 메인 메모리에 직접 가는 것은 비효율적이라서, 둘 사이의 속도 차이를 메우는 캐시 메모리가 있습니다. 이것도 아래에서 다룹니다.
MMU의 메모리 보호
프로세스는 각자 독립된 메모리 공간을 가져야 하고, 자기 공간에만 접근해야 합니다. 그래서 프로세스마다 접근해도 되는 주소 범위를 정해 두고, 그 밖으로 나가려 하면 trap(운영체제에 알리는 예외)을 일으켜 막습니다.
가장 간단한 방법은 base 레지스터와 limit 레지스터를 쓰는 것입니다.
- base 레지스터: 그 프로세스가 메모리에서 시작하는 물리 주소
- limit 레지스터: 그 프로세스의 크기
프로세스가 접근해도 되는 합법적인 주소 x의 범위는 다음과 같습니다.
base <= x < base + limit물리 메모리
┌──────────────────┐ 0
│ 운영체제 │
├──────────────────┤ 30000 ← base
│ │
│ 프로세스 A │ limit = 12000
│ │
├──────────────────┤ 42000 (base + limit)
│ 프로세스 B │ ← A가 여기를 건드리면 trap
└──────────────────┘아래 그림에서는 base가 300040, limit가 120900이므로, 이 프로세스는 300040 이상 420940(300040 + 120900) 미만의 주소에만 접근할 수 있습니다.
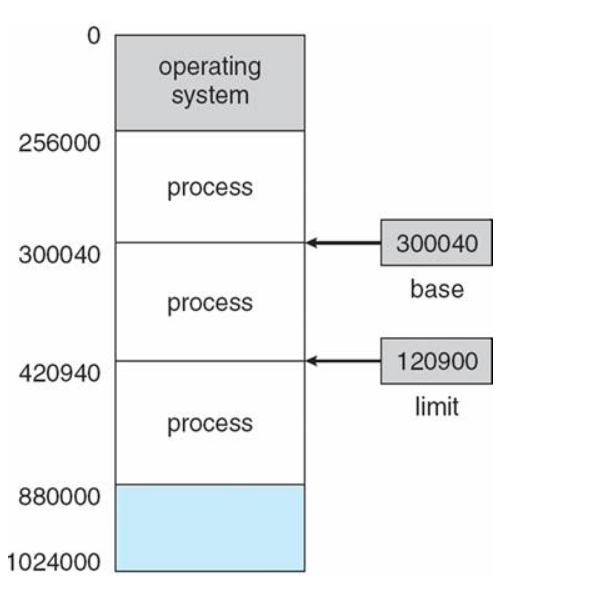
그림 출처: gyoogle 기술 면접 정리, Memory
이 범위를 벗어나면 trap이 발생하고, 운영체제가 그 프로세스를 보통 강제 종료합니다. 리눅스에서 흔히 보는 Segmentation fault가 이런 경우입니다. 안전을 위해 base와 limit 레지스터는 커널 모드에서만 바꿀 수 있게 설계되어 있습니다. 사용자 프로그램이 자기 범위를 마음대로 넓히면 보호가 의미 없어지기 때문입니다.
메모리를 나눠 주는 방법
여러 프로세스를 동시에 메모리에 올려 두는 다중 프로그래밍 시스템에서는, 메모리를 프로세스들에게 그때그때 나눠 주는(동적으로 분할하는) 관리가 필요합니다. 방법은 크게 두 가지입니다.
| 방식 | 뜻 |
|---|---|
| 연속 할당 | 프로그램 전체를 메모리의 한 덩어리 공간에 이어서 올림 |
| 불연속 할당 | 프로그램을 조각내서 서로 떨어진 공간에 나눠 올릴 수 있음 |
연속 메모리 할당
고정 분할
메모리를 미리 정해진 크기의 칸(파티션)으로 나눠 두고, 프로세스를 한 칸에 하나씩 넣습니다.
- 문제: 칸보다 작은 프로세스가 들어가면 칸 안에 남는 공간이 생기는데, 이 공간은 다른 프로세스가 쓸 수 없습니다. 이것을 내부 단편화라고 합니다.
동적 분할 (가변 분할)
칸을 미리 나누지 않고, 프로세스가 올 때마다 딱 그 크기만큼 잘라서 줍니다.
- 문제: 프로세스들이 들어왔다 나가기를 반복하면 메모리 곳곳에 작은 빈 공간이 흩어집니다. 빈 공간을 다 더하면 충분한데, 한 덩어리로 이어진 공간이 없어서 새 프로세스를 못 올립니다. 이것을 외부 단편화라고 합니다.
빈 공간이 여러 개일 때 어디에 넣을지 고르는 방법도 있습니다.
| 방법 | 고르는 기준 |
|---|---|
| 최초 적합 (First Fit) | 처음부터 훑다가 들어갈 수 있는 첫 번째 빈 공간 |
| 최적 적합 (Best Fit) | 들어갈 수 있는 빈 공간 중 가장 작은 것 (남는 공간 최소) |
| 최악 적합 (Worst Fit) | 가장 큰 빈 공간 (남는 공간을 크게 남겨 다시 쓰기 좋게) |
외부 단편화가 심해지면 프로세스들을 한쪽으로 몰아서 빈 공간을 하나로 합치는 압축(compaction) 을 할 수 있지만, 메모리를 통째로 옮겨야 해서 비용이 큽니다.
내부 단편화와 외부 단편화
단편화는 기억 장치의 빈 공간이나 자료가 여러 조각으로 나뉘어 제대로 쓰지 못하는 현상입니다.
내부 단편화 (칸 안에 남는 공간)
┌───────────────┐
│ 프로세스 (7KB) │
│ ░░ 남음 3KB ░░ │ ← 10KB 칸에 7KB만 써서 3KB 낭비
└───────────────┘

외부 단편화 (칸 사이에 흩어진 공간)
┌──────┬────┬──────┬────┬──────┬────┐
│ P1   │빈2K│ P2   │빈3K│ P3   │빈2K│ ← 빈 공간 합계 7KB
└──────┴────┴──────┴────┴──────┴────┘
6KB짜리 프로세스가 와도 이어진 공간이 없어서 못 들어감| 구분 | 어디에 생기나 | 주로 생기는 방식 |
|---|---|---|
| 내부 단편화 | 할당된 공간 안쪽 | 고정 분할, 페이징 |
| 외부 단편화 | 할당된 공간들 사이 | 동적 분할, 세그멘테이션 |
불연속 메모리 할당
프로그램을 조각내서 메모리의 서로 다른 곳에 나눠 올리는 방식입니다. 먼저 용어부터 보겠습니다.
| 용어 | 뜻 |
|---|---|
| 페이지 (Page) | 프로세스를 같은 크기로 자른 조각 |
| 프레임 (Frame) | 메인 메모리를 페이지와 같은 크기로 자른 칸 |
| 세그먼트 (Segment) | 프로세스를 코드, 데이터, 스택처럼 의미 단위로 나눈 조각. 크기가 서로 다르고, 세그먼트 하나는 메모리에 연속으로 올라감 |
조각을 고정 크기로 자르면 페이징, 가변 크기로 자르면 세그멘테이션입니다.
페이징 (Paging)
프로세스를 같은 크기의 페이지로 자르고, 메모리의 빈 프레임 아무 데나 넣습니다. 어느 페이지가 어느 프레임에 있는지는 프로세스마다 가진 페이지 테이블에 적어 둡니다.
프로세스 (논리)          페이지 테이블          물리 메모리
┌─────────┐            ┌──────┬──────┐        ┌─────────┐ 프레임 0
│ 페이지 0 │ ─────────▶ │  0   │  5   │        ├─────────┤ 프레임 1  ← 페이지 2
├─────────┤            │  1   │  9   │        ├─────────┤ ...
│ 페이지 1 │            │  2   │  1   │        ├─────────┤ 프레임 5  ← 페이지 0
├─────────┤            └──────┴──────┘        ├─────────┤ ...
│ 페이지 2 │                                   ├─────────┤ 프레임 9  ← 페이지 1
└─────────┘                                   └─────────┘
주소 변환해 보기
논리 주소는 페이지 번호와 오프셋(페이지 안에서 몇 번째 바이트인지)으로 나눌 수 있습니다. 페이지 크기가 4KB(4,096바이트)이고 페이지 테이블이 위 그림과 같을 때를 Python으로 계산해 봤습니다.
PAGE_SIZE = 4096                     # 페이지 크기 4KB
page_table = {0: 5, 1: 9, 2: 1}      # 페이지 번호 -> 프레임 번호

def translate(logical):
    page = logical // PAGE_SIZE      # 몇 번째 페이지인지
    offset = logical % PAGE_SIZE     # 페이지 안에서 몇 번째 칸인지
    if page not in page_table:
        return f"논리 주소 {logical}: {page}번 페이지가 메모리에 없음 -> 페이지 부재"
    frame = page_table[page]
    physical = frame * PAGE_SIZE + offset
    return f"논리 주소 {logical} = 페이지 {page}, 오프셋 {offset} -> 프레임 {frame} -> 물리 주소 {physical}"

for addr in [100, 8200, 13000]:
print(translate(addr))논리 주소 100 = 페이지 0, 오프셋 100 -> 프레임 5 -> 물리 주소 20580
논리 주소 8200 = 페이지 2, 오프셋 8 -> 프레임 1 -> 물리 주소 4104
논리 주소 13000: 3번 페이지가 메모리에 없음 -> 페이지 부재MMU가 실제로 하는 일이 바로 이 계산입니다. 페이지 테이블을 매번 메모리에서 읽으면 느리기 때문에, 최근에 쓴 변환 결과를 저장해 두는 작은 캐시인 TLB(Translation Lookaside Buffer)를 함께 씁니다.
페이징의 단편화
- 어떤 페이지든 빈 프레임 아무 데나 들어가므로 외부 단편화가 없습니다.
- 대신 프로세스 크기가 페이지 크기로 딱 나누어떨어지지 않으면, 마지막 페이지에 빈 공간이 남습니다. 내부 단편화가 조금 생깁니다.
import math
PAGE_SIZE = 4096
process_size = 10_000                  # 프로세스 크기 10,000바이트
pages = math.ceil(process_size / PAGE_SIZE)
waste = pages * PAGE_SIZE - process_size
print(f"필요한 페이지 수: {pages}개")
print(f"마지막 페이지에서 남는 공간(내부 단편화): {waste}바이트")필요한 페이지 수: 3개
마지막 페이지에서 남는 공간(내부 단편화): 2288바이트세그멘테이션 (Segmentation)
프로세스를 코드, 데이터, 스택, 힙처럼 의미 있는 단위(세그먼트) 로 나눕니다. 세그먼트마다 크기가 다르고, 각 세그먼트의 시작 주소(base)와 길이(limit)를 세그먼트 테이블에 적어 둡니다. 앞에서 본 base/limit 보호를 세그먼트마다 하는 셈입니다.
- 세그먼트 크기에 딱 맞춰 할당하므로 내부 단편화가 없습니다.
- "코드 세그먼트는 읽기만 가능"처럼 의미 단위로 보호·공유 설정을 하기 좋습니다.
- 동적 분할처럼 하나의 큰 덩어리가 아니라 여러 세그먼트로 나눠 올리므로, 메모리를 더 효율적으로 쓰고 관리 부담도 줄어듭니다.
- 하지만 크기가 제각각인 덩어리들이 들어왔다 나가면서 외부 단편화가 생깁니다.
그래서 실제 운영체제는 세그먼트를 다시 페이지로 잘게 나누는 페이지드 세그멘테이션을 쓰거나, 요즘 x86-64나 ARM의 리눅스처럼 사실상 페이징만 씁니다.
가상 메모리 (Virtual Memory)
가상 메모리는 프로세스 전체를 메모리에 올리지 않고, 지금 필요한 부분만 올려서 실행하는 기법입니다. 나머지는 디스크에 두었다가 필요해지면 그때 가져옵니다. 덕분에 실제 메모리보다 큰 프로그램도 실행할 수 있고, 더 많은 프로세스를 동시에 올릴 수 있습니다.
- 필요할 때만 페이지를 가져오는 방식을 요구 페이징(Demand Paging) 이라고 합니다.
- 필요한 페이지가 메모리에 없으면 페이지 부재(Page Fault) 가 발생하고, 운영체제가 디스크에서 그 페이지를 가져온 뒤 실행을 이어 갑니다.
아래 그림의 왼쪽이 프로세스 하나가 보는 가상 메모리입니다. 프로세스 입장에서는 하나로 이어진 공간이지만, 실제로는 조각마다 RAM의 여기저기에 흩어져 있거나(다른 프로세스의 메모리를 피해서), 아직 디스크에 있습니다.
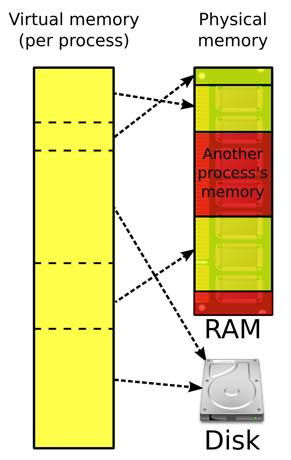
그림 출처: Wikimedia Commons (Ehamberg, CC BY-SA 3.0)
네 가지 방식 비교
| 방식 | 전부 올려야 하나 | 외부 단편화 | 내부 단편화 | 특징 |
|---|---|---|---|---|
| 단순 페이징 | 예 | 없음 | 조금 있음 | 같은 크기 페이지로 나눠 아무 프레임에나 |
| 단순 세그멘테이션 | 예 | 있음 | 없음 | 의미 단위로 나눔, 동적 분할보다 효율적 |
| 가상 메모리 페이징 | 아니요 (필요한 페이지만) | 없음 | 조금 있음 | 필요할 때 자동으로 불러옴, 관리가 복잡해 오버헤드 있음 |
| 가상 메모리 세그멘테이션 | 아니요 (필요한 세그먼트만) | 있음 | 없음 | 필요할 때 자동으로 불러옴, 관리가 복잡해 오버헤드 있음 |
스와핑 (Swapping)
스와핑은 메모리에 있던 내용을 잠시 디스크의 스왑 영역으로 내보내고(swap out), 필요할 때 다시 메모리로 가져오는(swap in) 것입니다.
- 옛날 방식은 프로세스 전체를 통째로 내보냈습니다.
- 요즘 페이징 시스템에서는 주로 페이지 단위로 내보내고 가져옵니다.
- 메모리가 너무 모자라서 스와핑이 끊임없이 일어나면, CPU는 거의 놀고 디스크만 바쁜 스래싱(Thrashing) 상태가 됩니다. 이건 페이지 교체 알고리즘에서 다시 봅니다.
메모리 과할당 (Over-allocating)
과할당은 실제 메모리 크기보다 더 많은 메모리를 프로세스들에게 나눠 준 상황입니다. 가상 메모리 덕분에 운영체제는 사용자가 눈치채지 못하게 "메모리가 충분한 척" 할 수 있습니다.
그런데 다음 순서로 일이 벌어지면 과할당이 드러날 위기가 옵니다.
- 프로세스 실행 도중 페이지 부재가 발생
- 그 페이지가 디스크 어디에 있는지 찾음
- 메모리의 빈 프레임에 올려야 하는데, 모든 프레임이 사용 중이라 빈 프레임이 없음
빈 프레임을 만드는 방법은 두 가지입니다.
| 방법 | 내용 | 문제 |
|---|---|---|
| 1. 프로세스 종료 | 메모리에 있는 프로세스 하나를 끝내서 자리 확보 | 사용자 프로그램이 갑자기 꺼지므로 들킴 |
| 2. 스왑 아웃 | 메모리에 있는 페이지를 디스크로 내보내 자리 확보 | 사용자는 눈치채지 못함 |
페이징은 시스템 효율을 높이려고 운영체제가 스스로 선택한 방식이므로, 사용자에게 들키지 않고 처리해야 합니다. 그래서 2번, 즉 페이지 교체로 해결합니다. (메모리가 정말 바닥나면 리눅스는 결국 1번에 해당하는 OOM Killer를 씁니다. 메모리 누수와 OOM 참고)
페이지 교체
페이지 교체는 빈 프레임이 없을 때, 메모리에 있는 페이지 하나(희생 페이지, victim)를 골라 내보내고 그 자리에 필요한 페이지를 올리는 것입니다.
- 프로세스 실행 도중 페이지 부재 발생
- 필요한 페이지가 디스크 어디에 있는지 찾음
- 메모리에 빈 프레임이 있는지 확인
- 빈 프레임이 있으면 그 프레임을 사용
- 없으면 victim 프레임을 골라 디스크에 기록하고, 페이지 테이블을 고침
- 비운 프레임에 필요한 페이지를 올리고 페이지 테이블을 고침
- 멈췄던 명령어부터 프로세스를 다시 실행
교체가 끝나면 아무 일도 없었던 것처럼 프로세스를 계속 실행해야 합니다. 그러려면 교체할 때 드는 오버헤드를 최대한 줄여야 합니다.
오버헤드를 줄이는 방법
빈 프레임이 없으면 디스크에 두 번 접근하게 됩니다. victim을 디스크에 쓸 때 한 번, 필요한 페이지를 읽어 올 때 한 번입니다. 교체가 잦으면 디스크 입출력이 쌓여 크게 느려집니다.
방법 1: 변경 비트(dirty bit) 쓰기
페이지마다 "메모리에 올라온 뒤로 내용이 바뀌었는지"를 나타내는 변경 비트를 둡니다. victim이 정해지면 이 비트를 확인합니다.
| 변경 비트 | 뜻 | 내보낼 때 |
|---|---|---|
| set (1) | 메모리의 내용이 디스크와 달라짐 (수정됨) | 디스크에 써야 함 |
| clear (0) | 메모리의 내용이 디스크와 똑같음 | 디스크에 쓸 필요 없이 그냥 버리면 됨 |
수정되지 않은 페이지는 쓰기를 건너뛸 수 있으므로, 디스크 접근을 최대 절반까지 줄일 수 있습니다.
방법 2: 좋은 교체 알고리즘 고르기
앞으로 페이지 부재가 덜 나도록 victim을 잘 고르는 것입니다. FIFO, OPT, LRU 같은 알고리즘이 있고, 실제 시뮬레이션 결과와 함께 페이지 교체 알고리즘에서 자세히 봅니다.
캐시 메모리
캐시 메모리는 메인 메모리에 있는 내용 일부를 임시로 복사해 두는, 작고 빠른 기억 장치입니다. CPU와 메인 메모리의 속도 차이 때문에 생기는 성능 저하를 줄입니다. CPU가 이미 봤던 데이터를 다시 찾을 때, 메모리까지 가지 않고 캐시에서 바로 꺼내 씁니다.
| 구분 | 메인 메모리 | 캐시 메모리 |
|---|---|---|
| 소자 | DRAM | SRAM (플립플롭 회로) |
| 속도 | 느림 | 빠름 |
| 용량·가격 | 크고 쌈 | 작고 비쌈 |
CPU와 기억 장치가 주고받는 순서
CPU가 주소 요청
   │
   ▼
캐시에 있나?
   ├── 있음 (Hit)  → 캐시에서 바로 CPU로 전달 → 끝
   └── 없음 (Miss) → 메인 메모리에서 가져옴 → 캐시에 저장 → CPU로 전달 → 끝
자주 쓰이는 데이터가 캐시에 들어 있어야 적중(Hit)이 늘고 빨라집니다. 그러려면 CPU가 어떤 데이터를 원할지 어느 정도 예측할 수 있어야 하는데, 이때 쓰는 것이 지역성의 원리입니다.
지역성 (Locality)
프로그램은 메모리 전체를 고르게 쓰지 않고, 한동안 특정 부분을 집중적으로 씁니다.
| 종류 | 뜻 | 예 |
|---|---|---|
| 시간 지역성 | 최근에 쓴 주소는 곧 다시 쓰일 가능성이 높음 | 반복문 안의 변수 i |
| 공간 지역성 | 방금 쓴 주소의 근처도 곧 쓰일 가능성이 높음 | 배열을 앞에서부터 차례로 읽기 |
캐시 라인 (Cache Line)
자주 쓰는 데이터를 캐시에 넣어 두어도, 원하는 데이터를 찾으려고 캐시 전체를 뒤져야 한다면 의미가 없습니다. 그래서 캐시는 데이터를 정해진 크기의 묶음(보통 64바이트) 으로 저장하고, 각 묶음에 "이게 메모리 어느 주소에서 온 것인지"를 나타내는 태그를 함께 붙여 둡니다. 이 묶음을 캐시 라인이라고 합니다.
- 주소만 보면 어느 칸을 확인할지 바로 계산할 수 있어서, 캐시 전체를 뒤지지 않고 빠르게 찾습니다.
- 한 바이트만 필요해도 주변 64바이트를 한꺼번에 가져오므로, 공간 지역성 덕을 봅니다.
캐시의 구조와 매핑 방식은 캐시 메모리에서 더 자세히 다룹니다.
정리
| 개념 | 비전공자 버전 요약 |
|---|---|
| 메인 메모리 | CPU가 바로 꺼내 쓰는 작업 책상. 실행하려면 여기 올라와야 함 |
| 논리 / 물리 주소 | 프로그램이 보는 주소 / 실제 RAM 위의 주소 |
| MMU | 논리 주소를 물리 주소로 번역하고, 남의 공간 침범을 막는 하드웨어 |
| base / limit | 시작 주소와 크기로 "여기서부터 여기까지만" 경계를 정함 |
| 내부 단편화 | 받은 칸 안에 남아서 버려지는 공간 |
| 외부 단편화 | 빈 공간은 많은데 조각조각이라 큰 프로그램이 못 들어감 |
| 페이징 | 같은 크기로 잘라 아무 빈칸에나 넣기. 외부 단편화 없음 |
| 세그멘테이션 | 코드, 데이터, 스택처럼 의미 단위로 나누기. 내부 단편화 없음 |
| 가상 메모리 | 지금 필요한 부분만 올려서 메모리가 큰 척하기 |
| 스와핑 | 안 쓰는 내용을 잠시 디스크로 내보냈다가 다시 가져오기 |
| 페이지 교체 | 빈자리가 없을 때 페이지 하나를 내보내고 필요한 페이지를 올리기 |
| 변경 비트 | 안 바뀐 페이지는 디스크에 다시 쓰지 않고 버려서 시간 절약 |
| 캐시 / 지역성 | 자주, 그리고 근처를 다시 쓰는 습관을 이용한 작고 빠른 저장소 |