
캐시 메모리 (Cache Memory)
캐시 메모리는 속도가 빠른 장치와 느린 장치 사이의 속도 차이 때문에 생기는 병목 현상을 줄이기 위한 메모리입니다. 자주 쓰는 데이터를 빠른 곳에 미리 복사해 두고, 다음에는 거기서 바로 꺼내 씁니다.
한눈에 보기
- 비유: 자주 보는 책을 책상 위에 두는 것과 같습니다.
- 책이 필요할 때마다 도서관(주기억장치)에 다녀오면 오래 걸립니다.
- 자주 보는 책 몇 권을 책상(캐시)에 올려 두면 손만 뻗으면 됩니다.
- 다만 책상은 좁고(용량이 작음) 넓히려면 비쌉니다(비용이 큼).
- 캐시가 쓰이는 곳의 예:
- CPU 코어와 메모리(RAM) 사이의 병목 현상 완화
- 웹 브라우저 캐시 파일: 한 번 받은 웹페이지 파일을 디스크에 저장해 두고, 다음에는 네트워크 대신 디스크에서 읽어 웹페이지와 하드디스크 사이의 병목을 완화
CPU 캐시가 동작하는 방식
CPU가 주기억장치에서 데이터를 읽어 올 때, 자주 사용하는 데이터를 캐시 메모리에 저장해 둡니다. 다음에 그 데이터가 필요하면 주기억장치보다 먼저 캐시 메모리를 확인해서 가져오므로 속도가 빨라집니다.
- CPU가 요청한 데이터가 캐시에 있으면 캐시 히트(Cache Hit) 입니다.
- 캐시에 없어서 더 느린 곳(다음 단계 캐시, 그래도 없으면 DRAM)에서 가져와야 하면 캐시 미스(Cache Miss) 입니다.
속도라는 장점을 얻는 대신, 용량이 작고 비용이 비싸다는 단점이 있습니다.
메모리 계층과 L1 · L2 · L3 캐시
          빠름 · 작음 · 비쌈
               ▲
        ┌──────────────┐
        │   레지스터    │  CPU 안
        ├──────────────┤
        │   L1 캐시     │  코어마다 따로, 수십 KB
        ├──────────────┤
        │   L2 캐시     │  보통 코어마다 따로, 수백 KB ~ 수 MB
        ├──────────────┤
        │   L3 캐시     │  여러 코어가 공유, 수 MB ~ 수십 MB
        ├──────────────┤
        │  주기억장치   │  RAM (DRAM), 수 GB ~ 수십 GB
        ├──────────────┤
        │ 보조기억장치  │  SSD, HDD
        └──────────────┘
               ▼
          느림 · 큼 · 쌈
아래 그림도 같은 이야기를 피라미드로 보여 줍니다. 위쪽(레지스터, 캐시)일수록 빠르고 비싸지만 작고, 아래쪽(RAM, 플래시, 하드디스크, 테이프)으로 갈수록 느리지만 싸고 큽니다. 또 위의 세 칸은 전원이 꺼지면 내용이 사라지고(power on), 아래는 전원이 꺼져도 남습니다(power off).
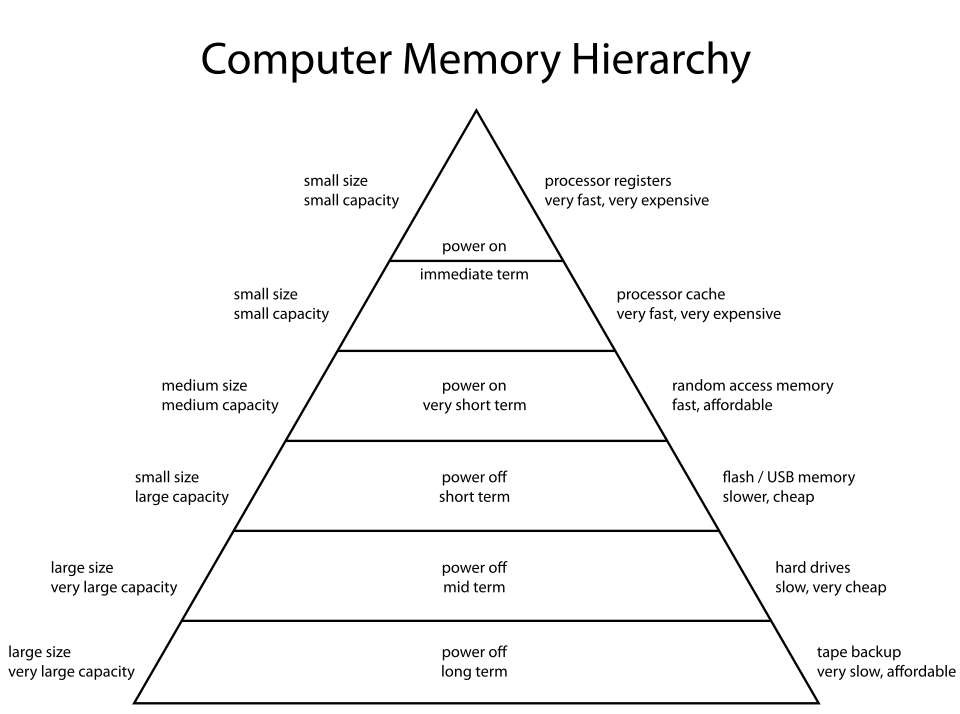
그림 출처: Wikimedia Commons (Public domain)
CPU에는 보통 캐시 메모리가 2~3단계로 들어 있고, 이를 L1, L2, L3 캐시라고 부릅니다. 속도와 크기에 따라 나눈 것입니다.
- 일반적으로 L1 캐시부터 확인합니다. CPU가 가장 빠르게 접근할 수 있는 곳이고, 여기서 데이터를 찾지 못하면 L2, 그다음 L3, 마지막으로 RAM으로 갑니다.
- 숫자가 커질수록 용량은 크지만 느립니다.
캐시는 어디에 있을까
예전 컴퓨터에서는 L1만 CPU 안에 있고, L2는 CPU와 RAM 사이(CPU 바깥)나 메인보드에, L3는 메인보드에 붙어 있는 경우가 있었습니다. 요즘 CPU는 L1, L2, L3 모두 CPU 칩 안에 들어 있습니다. 같은 칩 안에 있어야 빠르게 주고받을 수 있기 때문입니다.
멀티 코어 프로세서의 캐시
- 각 코어는 자기만의 L1 캐시를 가집니다.
- 예전 듀얼 코어 프로세서(예: 인텔 Core 2 Duo)에서는 두 코어가 L2 캐시를 공유했습니다.
- 요즘 프로세서는 보통 L2까지 코어마다 따로 두고, L3를 모든 코어가 공유합니다.
L1 캐시는 명령어용과 데이터용으로 나뉜다
L1 캐시는 보통 둘로 나뉩니다.
| 이름 | 담는 것 |
|---|---|
| I-Cache (Instruction Cache, 명령어 캐시) | 곧 실행할 명령어 |
| D-Cache (Data Cache, 데이터 캐시) | 명령어가 계산에 쓰는 데이터 |
예를 들어 L1 캐시가 128KB라면 64KB씩 나눠, 한쪽에는 명령어를, 다른 쪽에는 데이터를 저장하는 식입니다. 명령어를 꺼내 오는 일(인출 사이클)과 데이터를 읽고 쓰는 일이 서로 부딪히지 않고 동시에 일어날 수 있게 하려는 것입니다.
캐시가 작은 이유
캐시 메모리에는 SRAM을 씁니다. SRAM은 RAM에 쓰는 DRAM보다 훨씬 빠르지만, 같은 용량을 만드는 데 칩 면적을 훨씬 많이 차지하고 가격이 매우 비쌉니다. 그래서 크게 만들기 어렵습니다.
디스크 캐시
디스크 캐시는 주기억장치(RAM)와 보조기억장치(하드디스크) 사이에 있는 캐시입니다. 느린 디스크에서 읽은 내용을 RAM이나 디스크 자체의 버퍼에 담아 두고, 다시 읽을 때 디스크까지 가지 않게 합니다. 원리는 CPU 캐시와 같고, 계층만 한 단계 아래입니다.
캐시가 잘 맞는 이유: 참조 지역성
캐시가 작아도 효과가 큰 이유는, 프로그램이 데이터를 아무렇게나 쓰지 않고 일정한 경향을 보이기 때문입니다. 이것을 참조 지역성(Locality of Reference) 의 원리라고 합니다.
시간 지역성 (Temporal Locality)
한 번 참조된 데이터는 잠시 후에 또 참조될 가능성이 높습니다.
- 예: for 문이나 while 문의 조건 변수
i는 반복할 때마다 계속 다시 읽힙니다. - 비유: 방금 본 책은 곧 또 볼 가능성이 높으니 책상 위에 둡니다.
공간 지역성 (Spatial Locality)
참조된 데이터 근처에 있는 데이터가 잠시 후 사용될 가능성이 높습니다.
- 예: 배열을
A[0],A[1],A[2]처럼 차례로 읽는 경우 - 비유: 책 3쪽을 읽었으면 곧 4쪽, 5쪽도 읽을 테니 책을 통째로 가져옵니다.
그래서 캐시에 데이터를 저장할 때는 공간 지역성을 최대한 활용하기 위해, 요청한 데이터 하나만이 아니라 옆 주소의 데이터도 한 묶음으로 같이 가져와 앞으로 쓰일 것에 대비합니다. 이 묶음을 캐시 라인(Cache Line) 또는 블록이라고 하고, 요즘 CPU에서는 보통 64바이트입니다.
캐시 미스의 세 가지 종류
1. Cold Miss (콜드 미스)
해당 메모리 주소를 처음 불러서 생기는 미스입니다. 한 번도 가져온 적이 없으니 캐시에 있을 리가 없습니다. Compulsory Miss(강제 미스)라고도 합니다.
- 비유: 처음 보는 책은 무조건 도서관에 다녀와야 합니다.
2. Conflict Miss (충돌 미스)
캐시 메모리에 A와 B 데이터를 둘 다 저장해야 하는데, A와 B가 같은 캐시 자리에 배정되어 있어서 생기는 미스입니다. 빈 자리가 다른 곳에 있어도 정해진 자리가 하나뿐이라 서로 밀어냅니다. 아래에 나올 직접 사상(Direct Mapped) 캐시에서 많이 발생합니다.
- 비유: 핸드폰과 자동차 열쇠를 둘 다 오른쪽 주머니에만 넣기로 정해 두었는데, 주머니에는 하나만 들어갑니다. 열쇠를 넣으려고 핸드폰을 가방에 옮겼더니, 나중에 핸드폰을 오른쪽 주머니에서 찾을 때 없습니다. 왼쪽 주머니가 비어 있어도 규칙상 쓸 수 없는 상황입니다.
3. Capacity Miss (용량 미스)
캐시 메모리의 공간 자체가 부족해서 생기는 미스입니다. 자주 쓰는 데이터가 캐시 전체 크기보다 많으면, 어디에 넣든 무언가는 밀려나야 합니다.
- Conflict Miss는 자리 배정(주소 할당) 문제, Capacity Miss는 전체 공간 문제입니다.
그렇다고 캐시 크기를 키워서 해결하려 하면, 캐시 접근 속도가 느려지고 전력을 많이 쓰는 단점이 생깁니다. 그래서 크기 대신 아래와 같은 구조로 효율을 높입니다.
캐시의 구조와 작동 방식
직접 사상 캐시 (Direct Mapped Cache)
가장 기본적인 구조입니다. DRAM의 여러 주소가 캐시의 정해진 한 자리에 대응되는 다대일 방식입니다.
메모리 주소가 32개(00000 ~ 11111, 5비트)이고 캐시 자리가 8개(000 ~ 111, 3비트)인 상황을 예로 들어 보겠습니다.
 메모리 주소 (5비트)                  캐시 (8칸)
 ┌─────┬───────┐                   ┌─────────┬──────┬────────┐
 │태그  │인덱스  │                   │ 인덱스   │ 태그  │ 데이터  │
 ├─────┼───────┤                   ├─────────┼──────┼────────┤
 │ 00  │  000  │ ──┐               │   000   │  ??  │  ...   │ ◀── 네 주소가 이 한 칸을 두고 다툼
 │ 01  │  000  │ ──┤               │   001   │      │        │
 │ 10  │  000  │ ──┼────────────▶  │   010   │      │        │
 │ 11  │  000  │ ──┘               │   ...   │      │        │
 └─────┴───────┘                   │   111   │      │        │
└─────────┴──────┴────────┘- 00000, 01000, 10000, 11000 주소는 모두 캐시의 000번 자리에 매핑됩니다.
- 이때 뒤쪽 3비트(000)가 몇 번 자리인지 정하는 인덱스 필드, 인덱스를 뺀 앞부분(00, 01, 10, 11)이 그 자리에 지금 누가 들어 있는지 구분하는 태그 필드입니다.
- 이처럼 캐시의 각 자리는 인덱스 필드 + 태그 필드 + 데이터 필드로 구성됩니다.
주소를 인덱스와 태그로 나누는 것을 코드로 확인해 보겠습니다.
# 메모리 주소 32개(5비트), 캐시 칸 8개(3비트)인 직접 사상 캐시
for addr in [0b00000, 0b01000, 0b10000, 0b11000, 0b01101]:
    index = addr % 8      # 뒤 3비트 = 캐시의 몇 번 칸인지
    tag = addr // 8       # 앞 2비트 = 그 칸에 누가 들어 있는지 구분하는 이름표
print(f'주소 {addr:05b} -> 인덱스 {index:03b}, 태그 {tag:02b}')주소 00000 -> 인덱스 000, 태그 00
주소 01000 -> 인덱스 000, 태그 01
주소 10000 -> 인덱스 000, 태그 10
주소 11000 -> 인덱스 000, 태그 11
주소 01101 -> 인덱스 101, 태그 01장점은 간단하고 빠르다는 것입니다. 인덱스만 보면 확인할 자리가 딱 하나로 정해지기 때문입니다. 단점은 Conflict Miss가 자주 발생한다는 것입니다. 위 예처럼 같은 자리(000)에 배정된 데이터들을 번갈아 써야 하면 서로 계속 밀어냅니다.
아래는 크기를 키운 실제에 가까운 예입니다. 메인 메모리 블록 4096개가 캐시 줄(Cache Line) 64개에 나눠 담기는데, Block 0, 64, ... 처럼 64칸씩 떨어진 블록들이 모두 Cache Line 0 한 자리를 두고 다툭니다. 아래쪽의 주소 나눔에서 Index(7~2번 비트)가 몇 번 줄인지, Tag(13~8번 비트)가 그 줄에 누가 들어 있는지, Offset(1~0번 비트)이 블록 안의 몇 번째 바이트인지를 나타냅니다.
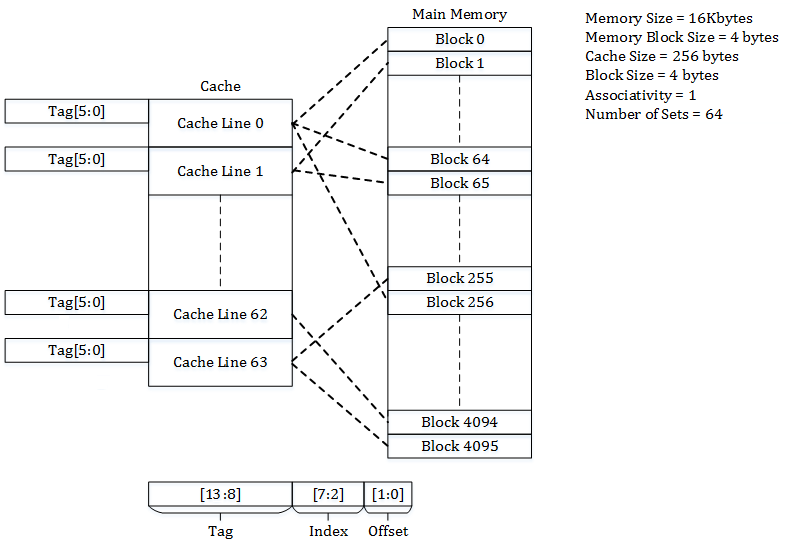
그림 출처: Wikimedia Commons (CC BY-SA 4.0)
완전 연관 캐시 (Fully Associative Cache)
캐시에 빈 자리가 있으면 아무 데나 저장하는 방식입니다.
- 저장할 때는 매우 간단합니다.
- 문제는 찾을 때입니다. 정해진 규칙이 없으니, 원하는 데이터가 있는지 확인하려면 캐시 안의 모든 블록을 한꺼번에 비교해야 합니다.
- 이렇게 한 번에 비교하려면 CAM(Content Addressable Memory, 내용으로 찾는 메모리) 이라는 특수한 메모리 구조가 필요한데, 가격이 매우 비쌉니다. 그래서 칸 수가 적은 특수한 캐시에만 쓰입니다.
집합 연관 캐시 (Set Associative Cache)
직접 사상과 완전 연관을 섞은 방식입니다.
- 주소로 어느 묶음(Set, 행) 에 들어갈지는 정해 두고, 그 묶음 안에서는 비어 있는 아무 칸(Way, 열) 에나 저장합니다.
- 한 묶음에 칸이 2개면 2-way, 4개면 4-way 집합 연관 캐시라고 부릅니다.
아래 그림 왼쪽은 직접 사상, 오른쪽은 2-way 집합 연관 캐시입니다. 직접 사상에서는 메모리 한 자리가 캐시 한 자리로만 갈 수 있지만, 2-way에서는 같은 묶음(Index)의 두 칸(Way 0, Way 1) 중 아무 곳에나 들어갈 수 있습니다.
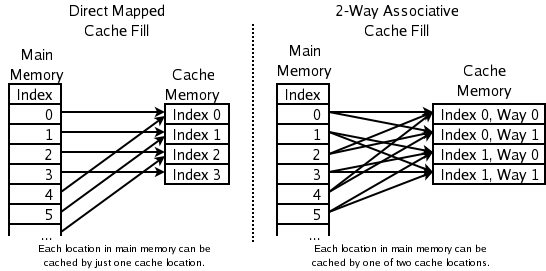
그림 출처: Wikimedia Commons (CC BY-SA 3.0)
| 방식 | 데이터를 둘 자리 | 찾을 때 비교할 칸 수 | Conflict Miss | 하드웨어 비용 |
|---|---|---|---|---|
| 직접 사상 | 딱 한 자리로 정해짐 | 1칸 | 많음 | 가장 쌈 |
| 집합 연관 | 정해진 묶음 안의 아무 칸 | 묶음 안의 칸 수만큼 | 중간 | 중간 |
| 완전 연관 | 캐시 전체의 아무 칸 | 전체 칸 | 거의 없음 | 가장 비쌈 |
직접 사상보다는 비교할 칸이 많아 찾는 과정이 조금 복잡하지만 충돌이 크게 줄고, 완전 연관보다는 충돌이 조금 있지만 훨씬 싸고 빠르게 찾을 수 있는 중간형입니다. 그래서 요즘 CPU 캐시는 대부분 이 방식(예: 8-way, 16-way)을 씁니다.
세 방식을 직접 비교해 보기
같은 자리(000)에 배정되는 두 주소 00000과 01000을 번갈아 읽는 상황을, 같은 크기(8칸)의 세 가지 캐시로 시뮬레이션해 보겠습니다.
def simulate(accesses, sets, ways):
    # sets: 묶음(행) 개수, ways: 한 묶음에 들어가는 칸 수
    cache = [[] for _ in range(sets)]   # 묶음마다 들어 있는 태그 목록 (앞쪽이 오래된 것)
    result = []
    for addr in accesses:
        index, tag = addr % sets, addr // sets
        row = cache[index]
        if tag in row:
            result.append('Hit')
            row.remove(tag)
        else:
            result.append('Miss')
            if len(row) == ways:
                row.pop(0)              # 칸이 꽉 찼으면 가장 오래 안 쓴 것을 내보냄
        row.append(tag)
    return result

seq = [0b00000, 0b01000, 0b00000, 0b01000, 0b00000]
print('직접 사상 (8묶음 x 1칸):', simulate(seq, sets=8, ways=1))
print('2-way 집합 연관 (4묶음 x 2칸):', simulate(seq, sets=4, ways=2))
print('완전 연관 (1묶음 x 8칸):', simulate(seq, sets=1, ways=8))직접 사상 (8묶음 x 1칸): ['Miss', 'Miss', 'Miss', 'Miss', 'Miss']
2-way 집합 연관 (4묶음 x 2칸): ['Miss', 'Miss', 'Hit', 'Hit', 'Hit']
완전 연관 (1묶음 x 8칸): ['Miss', 'Miss', 'Hit', 'Hit', 'Hit']- 처음 두 번의 Miss는 세 방식 모두 생기는 Cold Miss입니다.
- 직접 사상 캐시는 나머지 7칸이 비어 있는데도 두 주소가 같은 칸을 두고 서로 밀어내서, 이후로도 계속 Conflict Miss가 납니다.
- 집합 연관 캐시는 한 묶음에 칸이 2개라 두 주소가 함께 들어갈 수 있어서 Hit가 됩니다.
꽉 찬 칸에서 무엇을 내보낼지 정하는 규칙(위 코드에서는 가장 오래 안 쓴 것을 내보내는 LRU)은 LRU와 TTL에서 다룬 것과 같은 아이디어입니다.
개발할 때 알아 두면 좋은 점
- 배열을 앞에서부터 차례로 읽는 코드는 공간 지역성 덕분에 캐시 히트가 많아 빠릅니다.
- 2차원 배열을 행 방향으로 읽을지 열 방향으로 읽을지에 따라 속도가 크게 달라질 수 있는 것도 같은 이유입니다. (C 같은 언어는 같은 행의 원소가 메모리에 붙어 있음)
- 프로그램의 메모리가 어떻게 배치되는지는 메모리 구조, 운영체제의 메모리 관리는 메모리 관리를 참고하세요.
정리
| 개념 | 비전공자 버전 요약 |
|---|---|
| 캐시 메모리 | 자주 쓰는 데이터를 빠른 곳에 복사해 두는 책상 |
| 캐시 히트 / 미스 | 책상에 있으면 히트, 없어서 도서관에 가야 하면 미스 |
| L1 · L2 · L3 | 숫자가 작을수록 빠르고 작음. 요즘은 모두 CPU 칩 안에 있음 |
| I-Cache / D-Cache | L1을 명령어용과 데이터용으로 나눈 것 |
| 시간 지역성 | 방금 쓴 것은 곧 또 씀 |
| 공간 지역성 | 쓴 것의 옆자리도 곧 씀. 그래서 묶음(캐시 라인)으로 가져옴 |
| Cold / Conflict / Capacity Miss | 처음이라서 / 자리 배정이 겹쳐서 / 공간이 모자라서 생기는 미스 |
| 직접 사상 | 자리가 하나로 정해짐. 빠르지만 충돌이 잦음 |
| 완전 연관 | 아무 자리나 씀. 충돌은 없지만 찾기가 비쌈 |
| 집합 연관 | 묶음은 정하고 그 안에서는 자유. 요즘 CPU의 표준 |