
릴레이션 · 스키마 · 속성
관계형 DB의 기본 용어(릴레이션, 튜플, 애트리뷰트, 도메인)와 릴레이션의 규칙, 스키마 3단계와 데이터 독립성, 그리고 속성의 분류를 모았습니다.
릴레이션이란? (튜플/애트리뷰트/도메인)
릴레이션(Relation) = 행과 열로 이루어진 테이블이라고 생각하면 됩니다. 엑셀 시트를 떠올리면 쉽습니다.
        [애트리뷰트] (열, 컬럼)
         이름   나이   부서
튜플 →   철수   28    개발팀
(행)     영희   31    기획팀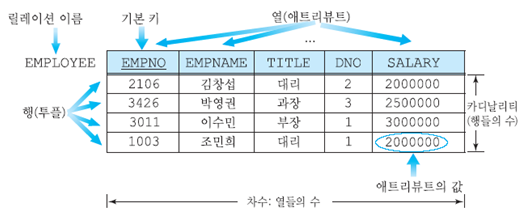
- 튜플(Tuple) = 행 하나. 파일로 치면 레코드 한 줄입니다.
- 애트리뷰트(Attribute) = 열 하나. 데이터베이스를 구성하는 가장 작은 논리적 단위입니다.
- 도메인(Domain) = 하나의 애트리뷰트가 가질 수 있는 값의 타입과 범위입니다. 예를 들어 "나이" 컬럼의 도메인은 "0 이상의 정수"입니다. DB는 이 도메인을 기준으로 잘못된 값(예: 나이 = "가나다")이 들어오는 걸 막습니다.
숫자로 세는 용어도 따로 있습니다.
| 용어 | 의미 | 엑셀로 치면 |
|---|---|---|
| 카디널리티(Cardinality) | 튜플의 수 | 행의 개수 |
| 디그리 / 차수(Degree) | 애트리뷰트의 수 | 열의 개수 |
릴레이션은 데이터가 계속 쌓이고 지워지므로 시간에 따라 내용이 바뀝니다. 그래서 릴레이션은 두 가지로 나눠 이야기합니다.
- 릴레이션 스키마: "이 테이블은 어떤 열들로 이루어져 있는가" (틀, 설계도)
- 릴레이션 인스턴스: 그 틀에 실제로 채워진 데이터 (지금 이 순간의 내용물)
카디널리티는 행이 들어오고 지워질 때마다 수시로 바뀌지만, 차수는 테이블 설계(스키마)를 바꾸지 않는 한 그대로입니다.
릴레이션이 지켜야 할 규칙
엑셀 시트와 비슷해 보여도, 릴레이션에는 몇 가지 규칙이 있습니다.
- 똑같은 튜플(행)은 두 번 들어올 수 없습니다. 그래서 행을 구분할 키가 필요합니다.
- 튜플 사이에는 순서가 없습니다. 1번 행, 2번 행이라는 개념이 원래는 없습니다.
- 애트리뷰트(열) 사이에도 순서가 없습니다. 이름 열이 먼저든 나이 열이 먼저든 같은 릴레이션입니다.
- 애트리뷰트 이름은 겹치면 안 되지만, 값은 겹쳐도 됩니다. "나이" 열이 두 개일 수는 없지만, 28살이 여러 명일 수는 있습니다.
- 한 칸에는 더 쪼갤 수 없는 값(원자값) 하나만 들어갑니다. 이 규칙은 뒤의 정규화(1정규형)에서 다시 나옵니다.
- 튜플이 들어오고 지워지면서 릴레이션은 시간에 따라 계속 바뀝니다.
같은 것을 부르는 여러 이름
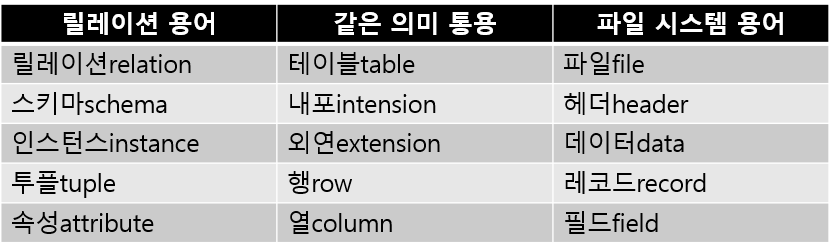
같은 개념을 관계형 DB 이론, 실무 SQL, 파일 시스템에서 각각 다르게 부릅니다. 시험에서도 이름만 바꿔서 나오니 묶어서 기억하면 편합니다.
| 관계형 DB 이론 | 실무 (SQL) | 파일 시스템 |
|---|---|---|
| 릴레이션 | 테이블 | 파일 |
| 튜플 | 행 (Row) | 레코드 |
| 애트리뷰트 | 열 (Column) | 필드 |
스키마 3단계와 데이터 독립성
하나의 데이터베이스를 누가 보느냐에 따라 다른 모습으로 보여주기 위한 구조가 ANSI/SPARC 3단계 스키마입니다. 건물로 비유하면 이렇습니다.
외부 스키마 (External)   →  "내가 쓰는 화면"      (응용 프로그램/사용자 관점)
개념 스키마 (Conceptual) →  "건물 전체 설계도"     (조직 전체의 논리적 구조)
내부 스키마 (Internal)   →  "실제 콘크리트/배관"   (물리적 저장 방식)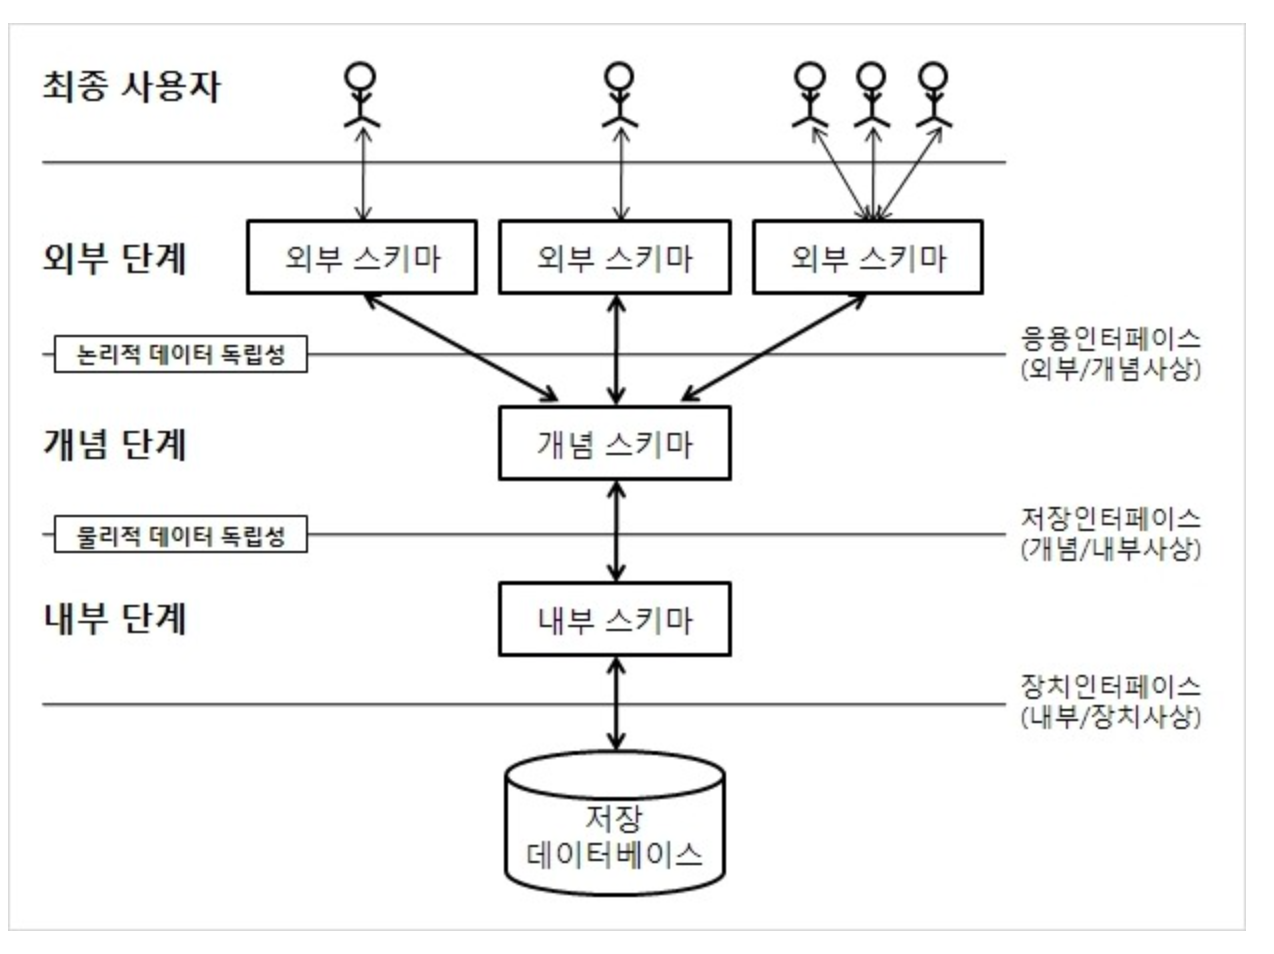
- 외부 스키마: 개별 사용자나 응용 프로그램이 보는 화면. 조직 전체 데이터 중 자기한테 필요한 일부만 봅니다.
- 개념 스키마: 모든 응용이 공유하는 전체 데이터 구조. 접근 권한, 보안, 무결성 규칙도 여기 포함됩니다.
- 내부 스키마: 실제로 디스크에 어떻게 저장되는지(레코드 형식, 저장 순서 등).
세 단계는 서로 **사상(Mapping)**으로 연결되어 있습니다. 어느 한 단계가 바뀌면 DBMS가 이 연결 정보만 고치기 때문에 위 단계는 영향을 받지 않습니다. 이걸 데이터 독립성이라 부릅니다.
외부/개념 사상: 사용자가 보는 화면(뷰)과 실제 테이블을 이어줍니다. → 논리적 데이터 독립성을 보장
개념/내부 사상: 실제 테이블과 디스크 저장 방식을 이어줍니다. → 물리적 데이터 독립성을 보장
논리적 데이터 독립성: 개념 스키마가 바뀌어도 외부 스키마는 안 바뀝니다. 예를 들어 테이블에 컬럼을 하나 추가해도, 기존 화면/코드는 고칠 필요가 없습니다.
물리적 데이터 독립성: 내부 스키마가 바뀌어도 개념 스키마는 안 바뀝니다. 예를 들어 조회 속도를 위해 인덱스를 새로 걸거나 저장 장치를 SSD로 바꿔도, 우리가 쓰는 테이블 정의나 SQL 문은 그대로입니다.
정리하면, 이 3단계 구조는 "화면 하나 바뀌었다고 저장 방식까지 다 뜯어고쳐야 하는" 상황을 막기 위한 설계입니다.
시험에서는 이렇게 나옵니다
- "전체 조직의 관점", "DB에 하나만 존재" 같은 말이 나오면 정답은 개념 스키마입니다.
- 개념/내부 사상이 보장하는 독립성은? 물리적 데이터 독립성입니다.
- 외부 스키마를 서브 스키마, 개념 스키마를 그냥 스키마라고 바꿔 부르기도 합니다.
속성(Attribute)은 어떻게 나뉘나
같은 "컬럼"이라도 성격에 따라 몇 가지로 나눠볼 수 있습니다.
생겨난 원인에 따라
- 기본 속성: 업무에서 자연스럽게 나온 원래 속성 (이름, 생년월일 등)
- 설계 속성: 업무엔 없지만 설계 과정에서 필요해서 새로 만든 속성 (예: 상품코드)
- 파생 속성: 다른 속성을 계산해서 만든 속성 (예: 나이는 생년월일로부터 계산 가능, 합계 금액은 단가×수량)
테이블 안에서의 역할에 따라
- PK 속성: 행을 구분하는 식별자 역할
- FK 속성: 다른 테이블을 가리키는 역할 (외래키)
- 일반 속성: 그 외 순수 데이터 값
값을 쪼갤 수 있는지에 따라
이 분류가 특히 중요한 이유는, 바로 다음에 나올 정규화와 직결되기 때문입니다.
- 단순 속성: 더는 못 쪼개는 값 하나 (나이, 성별)
- 복합 속성: 여러 세부 속성으로 쪼개지는 값 (주소 → 시/도, 구/군, 동/호수)
- 다치 속성: 한 칸에 값이 여러 개 들어갈 수 있는 속성 (취미 → 축구, 영화, 독서)
다치 속성은 테이블 한 칸에 여러 값을 몰아넣는 모양이라, 그대로 두면 검색/수정이 어려워집니다. 그래서 모델링 단계에서 보통 별도 테이블로 분리하는데, 이 "한 칸엔 값 하나만"이라는 규칙이 뒤에 나올 1정규형의 핵심 조건입니다.
파생 속성은 편하지만 관리가 까다롭다
파생 속성(예: 총금액 = 단가 × 수량)은 매번 계산하지 않고 미리 저장해 두니 조회가 빨라집니다. 대신 원래 값(단가, 수량)이 바뀔 때마다 같이 고쳐줘야 해서, 깜빡하면 값이 서로 안 맞게 됩니다. 그래서 꼭 필요한 곳에만 씁니다.
시험에서는 이렇게 나옵니다
- [사원이름, 단가, 수량, 총금액] 중 성격이 다른 하나는? 총금액 (혼자 파생 속성)
- "파생 속성은 조회 성능을 높이지만 데이터 정합성 유지에 유의해야 한다" → 맞는 말입니다.
- 업무에 원래 있던 게 아니라 시스템을 위해 코드나 일련번호로 만든 속성은 설계 속성입니다.
정리
| 개념 | 핵심 |
|---|---|
| 릴레이션 | 행과 열로 이루어진 테이블. 튜플(행), 애트리뷰트(열), 도메인(값의 타입과 범위) |
| 카디널리티 / 차수 | 튜플의 수 / 애트리뷰트의 수 |
| 스키마 / 인스턴스 | 틀(설계도) / 지금 채워진 데이터 |
| 릴레이션 규칙 | 중복 행 없음, 행·열 순서 없음, 한 칸엔 원자값 하나 |
| 같은 뜻의 이름 | 릴레이션=테이블=파일, 튜플=행=레코드, 애트리뷰트=열=필드 |
| 3단계 스키마 | 외부(사용자 화면) · 개념(전체 논리 구조) · 내부(물리 저장) |
| 데이터 독립성 | 논리적: 개념이 바뀌어도 외부 유지 / 물리적: 내부가 바뀌어도 개념 유지 |
| 속성 분류 | 원인(기본/설계/파생), 역할(PK/FK/일반), 쪼갤 수 있는지(단순/복합/다치) |
참고: 개인 Notion 학습 노트