
파일 시스템 (File System)
파일 시스템은 저장 장치에 있는 수많은 파일을 쉽게 찾고, 안전하게 보관하고, 관리할 수 있도록 정리하는 운영체제의 방법입니다. 하드디스크나 SSD에는 그냥 0과 1만 잔뜩 있을 뿐인데, 파일 시스템 덕분에 "문서 폴더의 보고서.txt"처럼 이름과 폴더로 다룰 수 있습니다.
한눈에 보기
- 비유: 저장 장치는 거대한 창고, 파일 시스템은 창고의 관리 대장과 선반 규칙입니다. 물건(데이터)을 어느 선반에 두었는지, 이름은 무엇인지, 언제 들어왔는지를 대장에 적어 두기 때문에, 창고가 아무리 커도 원하는 물건을 바로 찾을 수 있습니다.
- 관리 대장에 해당하는 부분이 메타 영역, 실제 물건이 놓인 선반이 데이터 영역입니다.
- 리눅스에서 실제로 쓰는 디렉터리 구조(
/home,/etc등)와 파일 권한은 파일 시스템과 권한에서 실습 위주로 다뤘습니다. 이 글은 운영체제 이론 쪽에서 파일 시스템을 봅니다.
특징
- 커널 영역에서 동작합니다. 프로그램이 파일을 열거나 읽을 때는 직접 디스크를 건드리지 않고, 시스템 콜로 커널에 부탁합니다.
- 파일을 만들고(Create), 읽고(Read), 고치고(Update), 지우는(Delete) CRUD 작업을 원활하게 하는 것이 목적입니다.
- 계층적 디렉터리 구조(폴더 안에 폴더)를 가집니다.
- 디스크 파티션마다 하나씩 둘 수 있습니다. 예를 들어 한 디스크를 둘로 나눠 한쪽은 ext4, 다른 쪽은 NTFS로 쓸 수 있습니다.
역할
| 역할 | 내용 |
|---|---|
| 파일 관리 | 파일을 만들고, 이름을 붙이고, 지우고, 찾기 |
| 보조 저장소 관리 | 디스크의 어느 블록이 비어 있고 어느 블록이 쓰이는지 관리 |
| 파일 무결성 보장 | 정전이나 오류가 나도 파일이 깨지지 않도록 보호 (예: 저널링) |
| 접근 방법 제공 | 순차 접근, 직접 접근 같은 읽기·쓰기 방식 제공 |
개발 목적
- 파일 관리: 수많은 파일을 이름과 디렉터리로 체계적으로 정리합니다.
- 하드디스크 용량을 효율적으로 쓰기: 빈 공간을 추적해서 낭비 없이 파일을 저장합니다.
- 하드디스크와 메인 메모리의 속도 차이를 줄이기: 디스크는 메모리보다 훨씬 느립니다. 그래서 파일 시스템은 자주 쓰는 파일 내용을 메모리에 잠시 담아 두는 버퍼 캐시를 함께 써서, 매번 디스크까지 가지 않게 합니다.
구조
파일 시스템은 크게 두 영역으로 나뉩니다.
| 영역 | 담는 내용 | 비유 |
|---|---|---|
| 메타 영역 | 파일 이름, 위치(어느 블록에 있는지), 크기, 만든 시간·고친 시간, 삭제 여부 같은 파일에 대한 정보 | 창고 관리 대장 |
| 데이터 영역 | 파일의 실제 내용 | 물건이 놓인 선반 |
리눅스에서는 파일 하나의 메타데이터를 inode라는 구조에 저장합니다. 파일을 지울 때 실제 내용을 바로 지우지 않고 메타 영역에서 "삭제됨"으로 표시만 하는 경우가 많은데, 삭제한 파일을 복구 프로그램으로 살릴 수 있는 이유가 이것입니다.
파일 접근 방법
1. 순차 접근 (Sequential Access)
처음부터 차례대로 읽고 쓰는 가장 간단한 방법입니다. 대부분의 연산이 read와 write입니다.
시작                          현재 위치               끝
 │                               │                   │
 ▼                               ▼                   ▼
[레코드0][레코드1][레코드2][레코드3][레코드4][레코드5]...
◀── 되감기(rewind) 읽거나 쓰면 ──▶ 앞으로 이동- 파일에는 현재 위치를 가리키는 포인터가 있습니다. read나 write 시스템 콜을 하면 그 위치에서 읽거나 쓰고, 포인터가 자동으로 앞으로 이동합니다.
- 뒤로 돌아가려면 정해진 거리(offset)만큼 되감기를 해야 합니다.
- 카세트테이프를 듣는 방식과 같아서 테이프 모델이라고도 합니다.
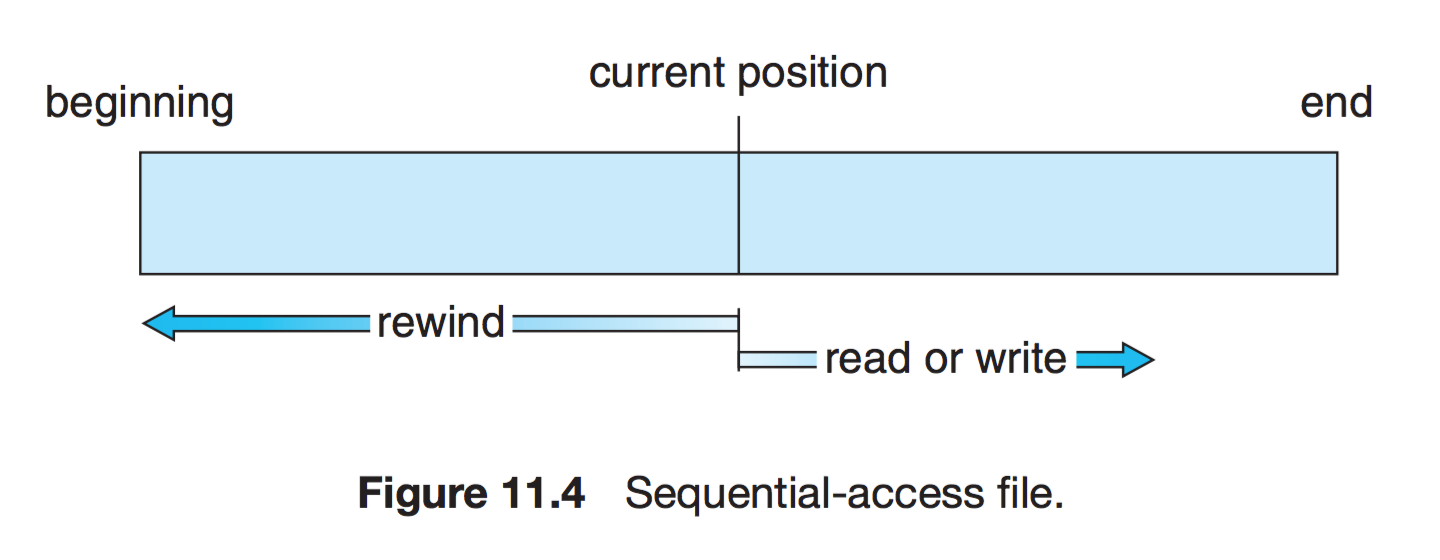
그림 출처: noep 블로그, 파일 시스템 정리 (원출처: Silberschatz 외, Operating System Concepts)
2. 직접 접근 (Direct Access)
순서와 상관없이 원하는 위치로 바로 가서 읽고 쓰는 방법입니다. 임의 접근(Random Access)이라고도 합니다.
[블록0][블록1][블록2][블록3][블록4][블록5][블록6]...
          ▲                    ▲     ▲
          │                    │     │
read 1번 블록 read 4번 write 5번 ← 순서 없이 바로 이동- 파일을 고정 크기 블록(레코드)이 번호대로 늘어선 것으로 보고, "n번 블록을 읽어 줘"처럼 요청합니다.
- 현재 위치를 가리키는 변수(
cp) 하나만 유지하면, 직접 접근 파일로 순차 접근도 쉽게 흉내 낼 수 있습니다. 매번 cp를 1씩 늘리면서 읽으면 되니까요. 반대로 순차 접근만으로 직접 접근을 흉내 내기는 비효율적입니다. - 많은 정보에 빠르게 접근해야 하는 데이터베이스에서 많이 씁니다.
아래 표가 직접 접근 파일로 순차 접근을 흉내 내는 방법입니다. 처음으로 가기(reset)는 cp = 0, 다음 것 읽기(read_next)는 cp번 블록을 읽고 cp를 1 늘리는 식입니다.
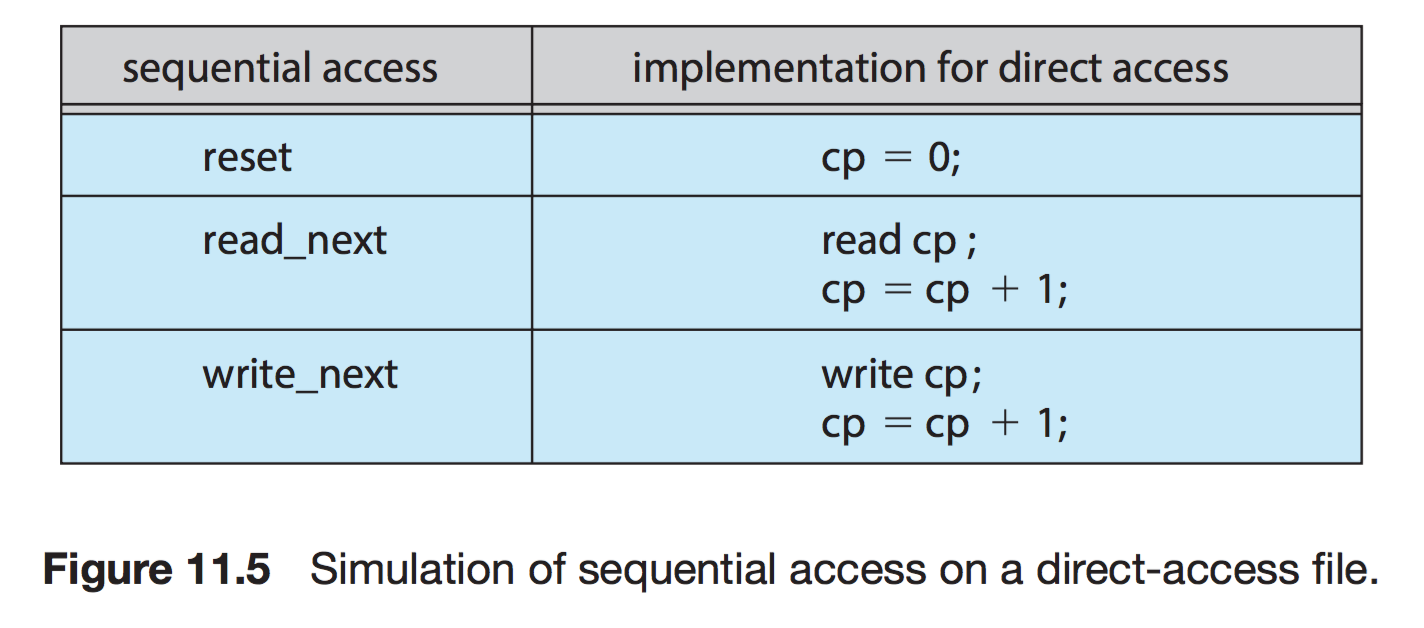
그림 출처: noep 블로그, 파일 시스템 정리 (원출처: Silberschatz 외, Operating System Concepts)
3. 색인 접근 (Indexed Access)
직접 접근을 바탕으로, 색인(index)을 먼저 만들어 두고 색인에서 위치를 찾은 뒤 그 블록으로 바로 가는 방법입니다.
색인 파일                       실제 파일
┌────────┬─────────┐
│ 이름    │ 블록 번호 │            [블록0][블록1][블록2][블록3]...
├────────┼─────────┤                          ▲
│ choi   │    3    │ ─────────────────────────┘
│ kim    │    0    │
│ park   │    2    │
└────────┴─────────┘- 책 맨 뒤의 찾아보기처럼, 크기가 큰 파일에서 원하는 내용을 빠르게 찾게 도와줍니다.
- 데이터베이스의 인덱스도 같은 아이디어입니다. 인덱스 글에서 볼 수 있습니다.
아래 그림에서는 색인 파일에서 Smith를 찾고, 거기 적힌 레코드 번호를 따라 실제 파일의 해당 레코드로 바로 갑니다.
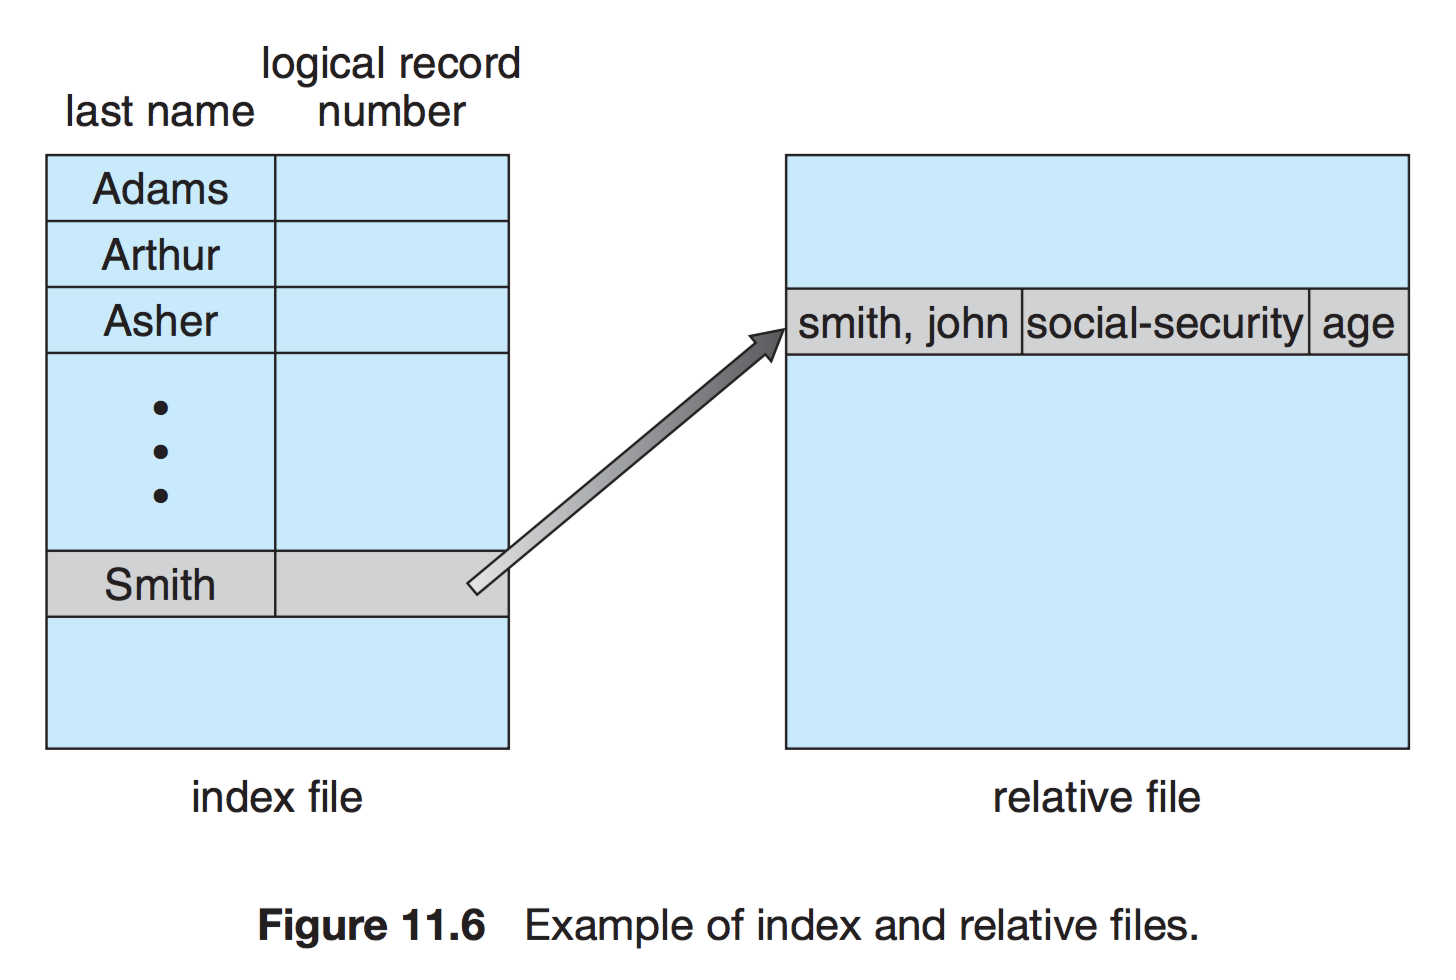
그림 출처: noep 블로그, 파일 시스템 정리 (원출처: Silberschatz 외, Operating System Concepts)
코드로 비교해 보기
학생 기록 5개를 16바이트짜리 고정 길이 레코드로 파일에 저장하고, 세 가지 방법으로 읽어 봤습니다. seek()는 파일 포인터를 원하는 위치로 옮기는 함수입니다.
RECORD = 16  # 레코드 하나의 크기 (16바이트로 고정)

# 학생 5명의 기록을 고정 길이 레코드로 파일에 저장
with open("students.dat", "w", encoding="ascii") as f:
    for i, name in enumerate(["kim", "lee", "park", "choi", "jung"]):
        f.write(f"{i:02d} {name}".ljust(RECORD - 1) + "\n")

# 1) 순차 접근: 처음부터 차례대로 읽기
with open("students.dat", encoding="ascii") as f:
    print("순차 접근:", [line.strip() for line in f])

# 2) 직접 접근: 3번 레코드로 바로 건너뛰기
with open("students.dat", encoding="ascii") as f:
    f.seek(3 * RECORD)                 # 3번 레코드의 시작 위치로 이동
    print("직접 접근(3번):", f.read(RECORD).strip())

# 3) 색인 접근: 이름 -> 레코드 번호 색인을 먼저 보고 바로 찾아가기
index = {"kim": 0, "lee": 1, "park": 2, "choi": 3, "jung": 4}
with open("students.dat", encoding="ascii") as f:
    f.seek(index["park"] * RECORD)
print("색인 접근(park):", f.read(RECORD).strip())순차 접근: ['00 kim', '01 lee', '02 park', '03 choi', '04 jung']
직접 접근(3번): 03 choi
색인 접근(park): 02 park디렉터리 구조
디렉터리(폴더)는 파일들을 묶어 정리하는 특별한 파일입니다. 어떻게 구성하느냐에 따라 여러 구조가 있습니다.
1단계 디렉터리
모든 파일이 디렉터리 하나에 들어 있는 가장 단순한 구조입니다.
       [ 루트 디렉터리 ]
     /    |     |     \
a.txt b.txt c.py data.csv- 모든 파일이 서로 다른 이름을 가져야 합니다. 사용자가 달라도 같은 이름을 쓸 수 없습니다.
- 파일이 많아지면 관리가 매우 어렵습니다.
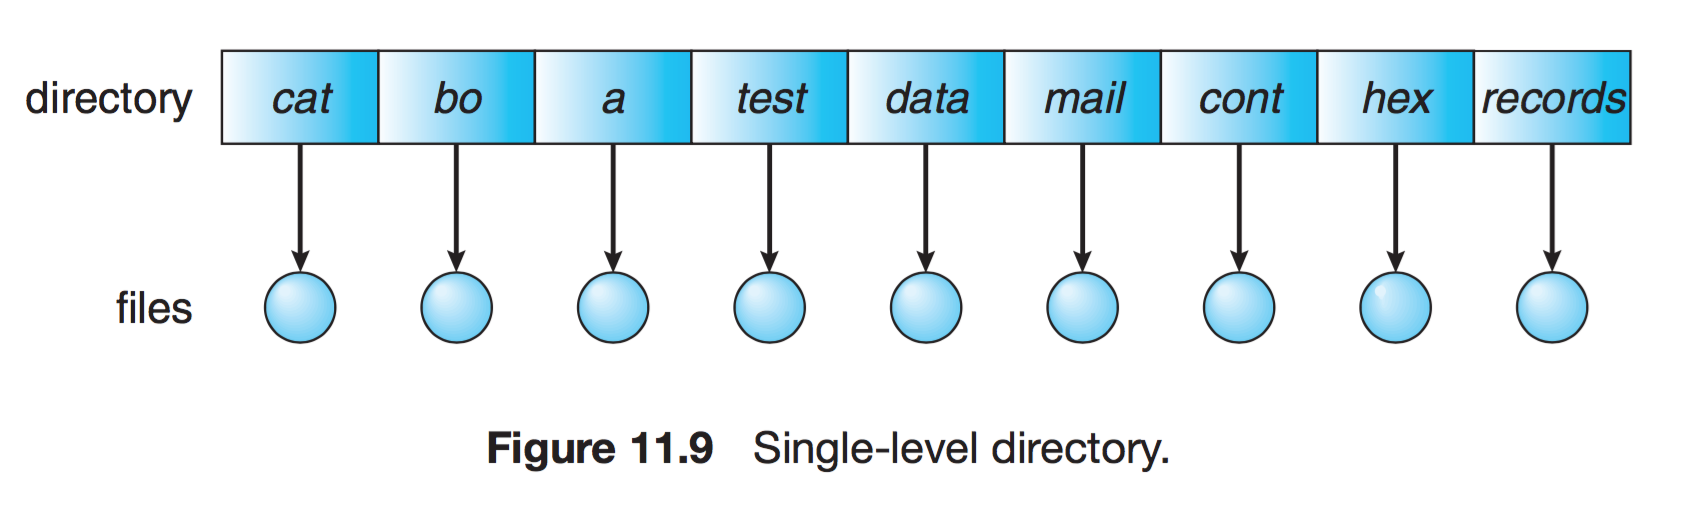
그림 출처: noep 블로그, 파일 시스템 정리 (원출처: Silberschatz 외, Operating System Concepts)
2단계 디렉터리
사용자마다 자기만의 디렉터리를 따로 만들어 줍니다.
                 [ MFD ]
            /       |       \
       [kim UFD] [lee UFD] [park UFD]
        /    \       |        |
a.txt b.txt a.txt c.py ← kim과 lee가 같은 이름 a.txt 사용 가능- MFD (Master File Directory): 사용자 이름이나 계정 번호로 색인된 최상위 디렉터리
- UFD (User File Directory): 사용자 한 명의 파일 디렉터리
- 사용자가 다르면 같은 파일 이름을 써도 됩니다. 하지만 한 사용자 안에서는 여전히 폴더를 더 나눌 수 없습니다.
아래 그림에서 user 1, 2, 3, 4가 모두 a라는 같은 이름의 파일을 갖고 있지만, 서로 다른 UFD에 있으니 문제없습니다.
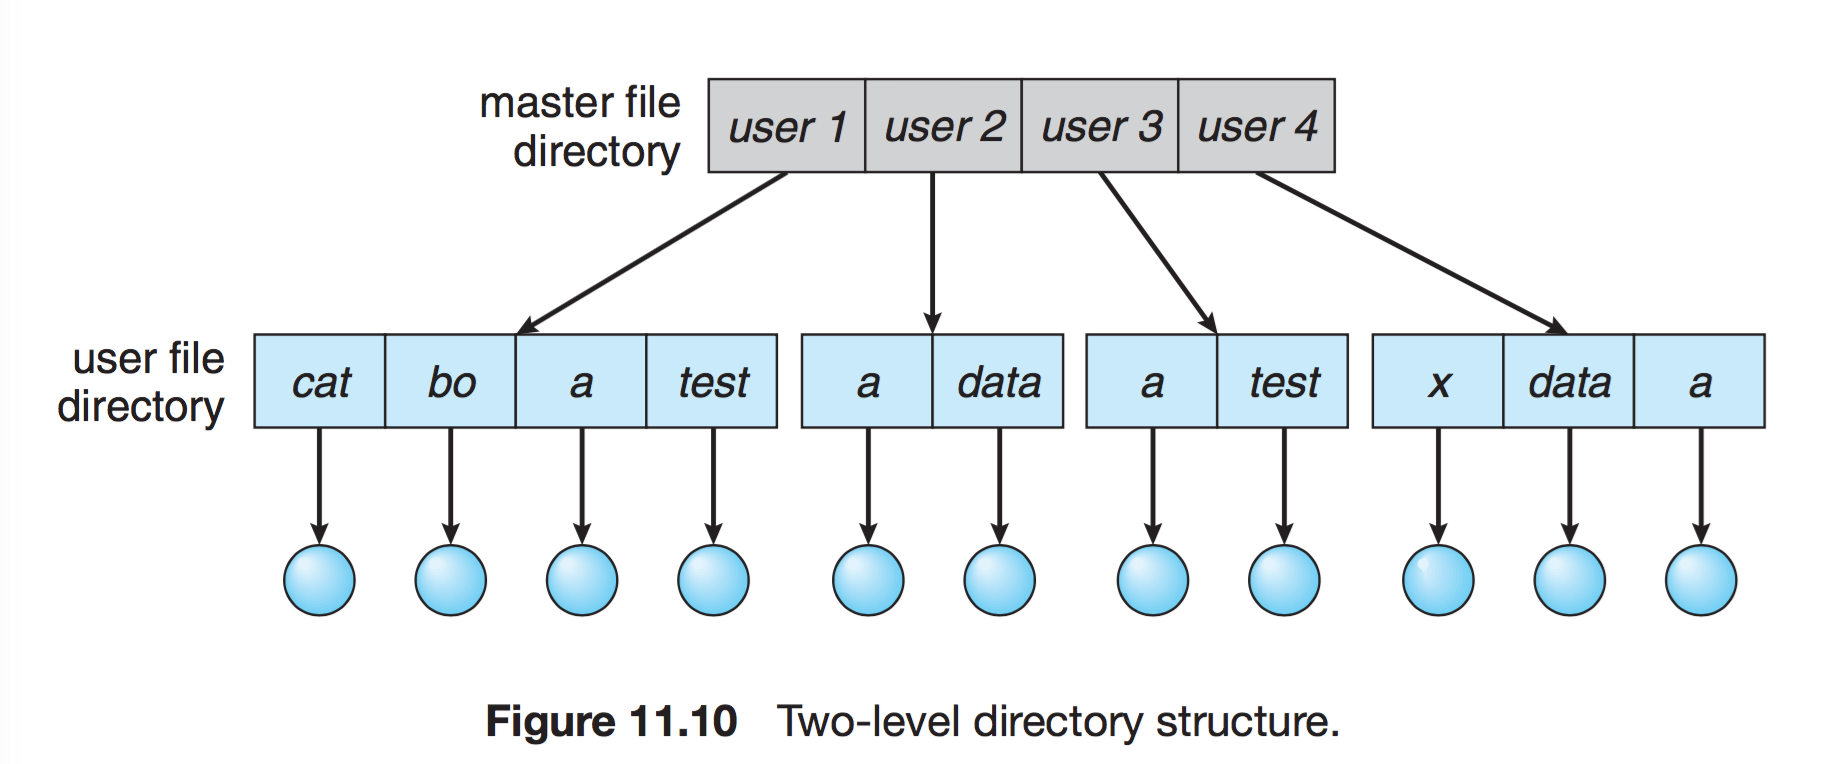
그림 출처: noep 블로그, 파일 시스템 정리 (원출처: Silberschatz 외, Operating System Concepts)
트리 구조 디렉터리
2단계 구조를 넓혀서 디렉터리 안에 디렉터리를 원하는 만큼 만들 수 있게 한 다단계 구조입니다. 지금 우리가 쓰는 대부분의 운영체제가 이 구조를 기본으로 합니다.
                 /
          /      |      \
       home     etc     usr
        |                |
       kim              bin
      /   \
  docs    photo
   |
report.txt → 경로: /home/kim/docs/report.txt- 디렉터리도 하나의 파일로 취급합니다. 각 항목에 비트 하나를 두고 일반 파일(0)인지 디렉터리 파일(1)인지 구분합니다.
- 경로는 루트에서 시작하는 절대 경로(
/home/kim/docs)와 현재 위치에서 시작하는 상대 경로(docs/report.txt)로 나타냅니다.
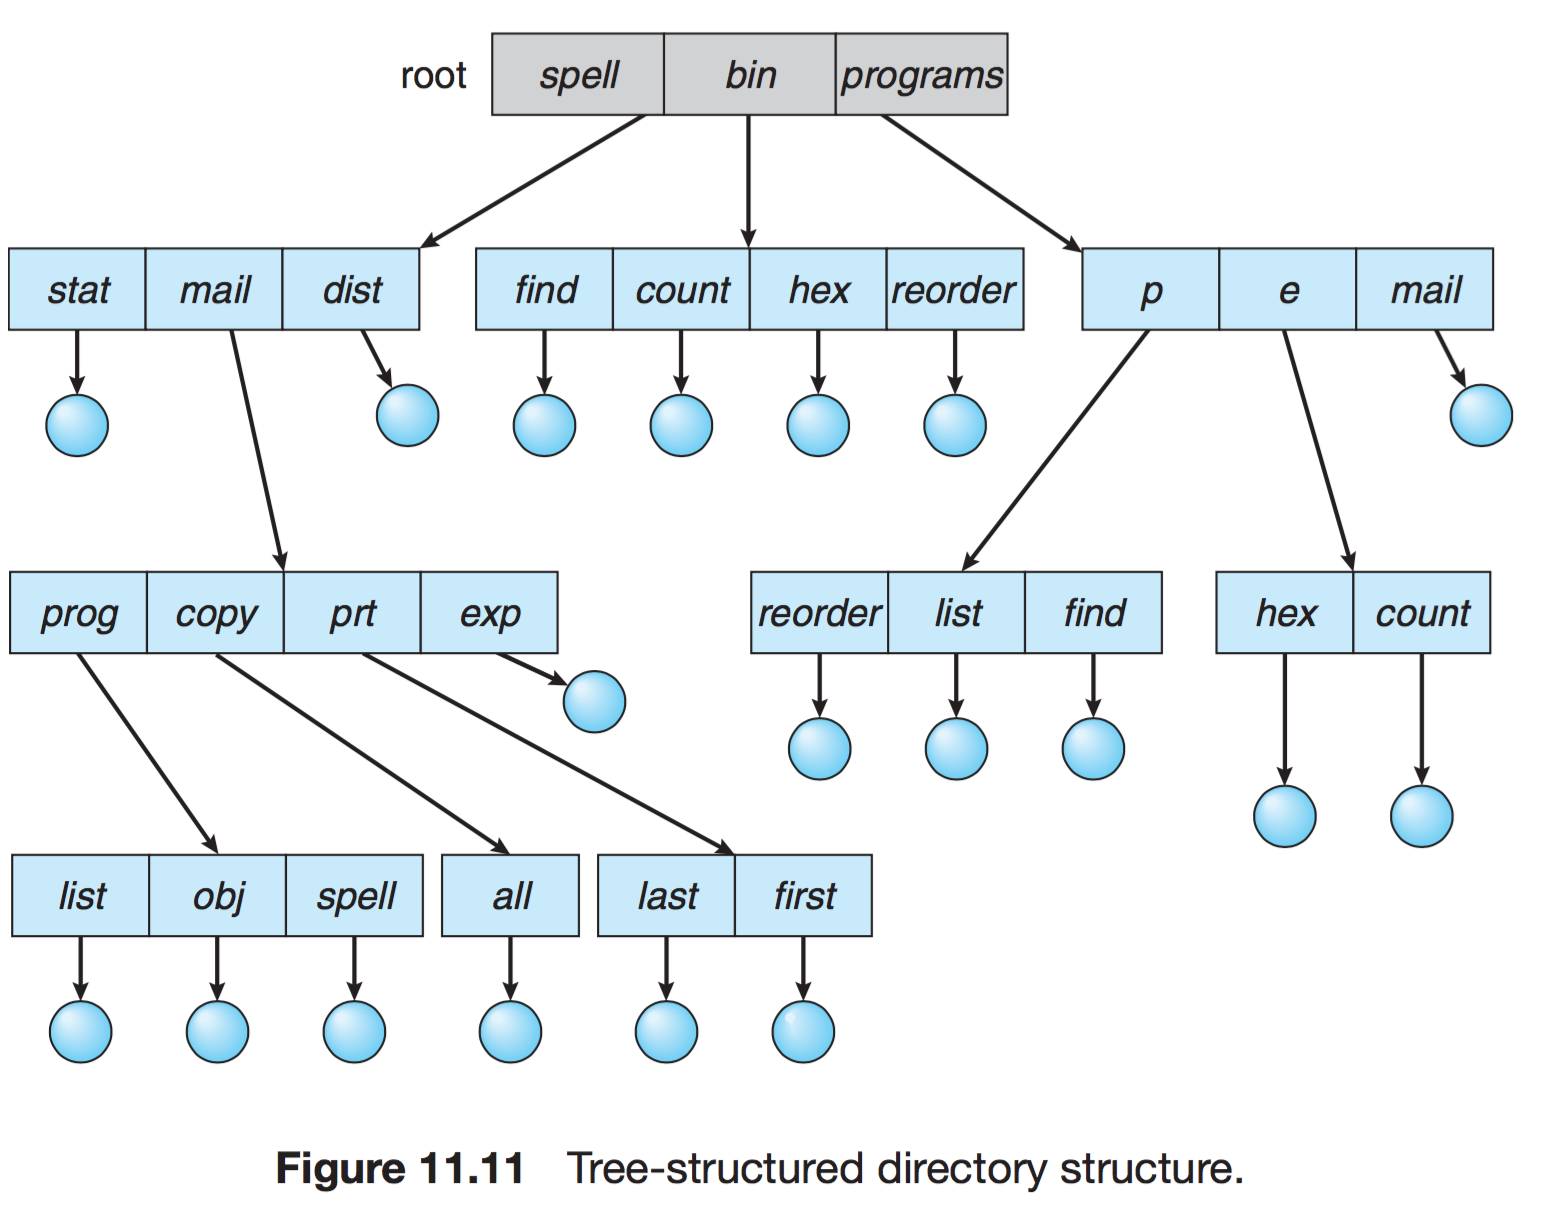
그림 출처: noep 블로그, 파일 시스템 정리 (원출처: Silberschatz 외, Operating System Concepts)
그래프 구조 디렉터리
트리 구조에 링크를 더해서, 하나의 파일이나 디렉터리를 여러 곳에서 함께 가리킬 수 있게 한 구조입니다. 리눅스의 링크(ln)가 이것입니다.
        /
     /     \
   kim     lee
    |       |
  project ◀─┘ (링크)     ← kim과 lee가 같은 project 폴더를 공유
    |
  main.py
링크를 자유롭게 허용하면 순환이 생길 수 있습니다. 예를 들어 a 안에 b가 있고, b 안에 다시 a를 가리키는 링크가 있으면, 폴더를 끝까지 훑는 프로그램이 영원히 돌게 됩니다. 이를 막는 방법은 두 가지입니다.
| 방법 | 내용 |
|---|---|
| 순환을 처음부터 막기 (비순환 그래프) | 하위 디렉터리를 가리키는 링크는 막고 파일에 대한 링크만 허용함. 또는 탐색할 때 링크는 따라가지 않고 우회함 |
| 순환을 허용하고 정리하기 (일반 그래프) | 가비지 컬렉션으로 전체 파일 시스템을 훑으며 접근 가능한 것을 모두 표시하고, 표시되지 않은(아무도 가리키지 않는) 것을 정리함 |
리눅스는 첫 번째 방식에 가깝습니다. 하드 링크는 디렉터리에는 만들 수 없게 막고, 디렉터리를 가리키는 심볼릭 링크는 find 같은 도구가 기본적으로 따라가지 않습니다.
아래 그림은 순환을 허용한 일반 그래프 구조입니다. avi 아래 book 디렉터리 안의 avi 항목이 다시 book을 가리켜 순환이 생겼고, avi와 jim의 book이 같은 디렉터리를 함께 가리킵니다.
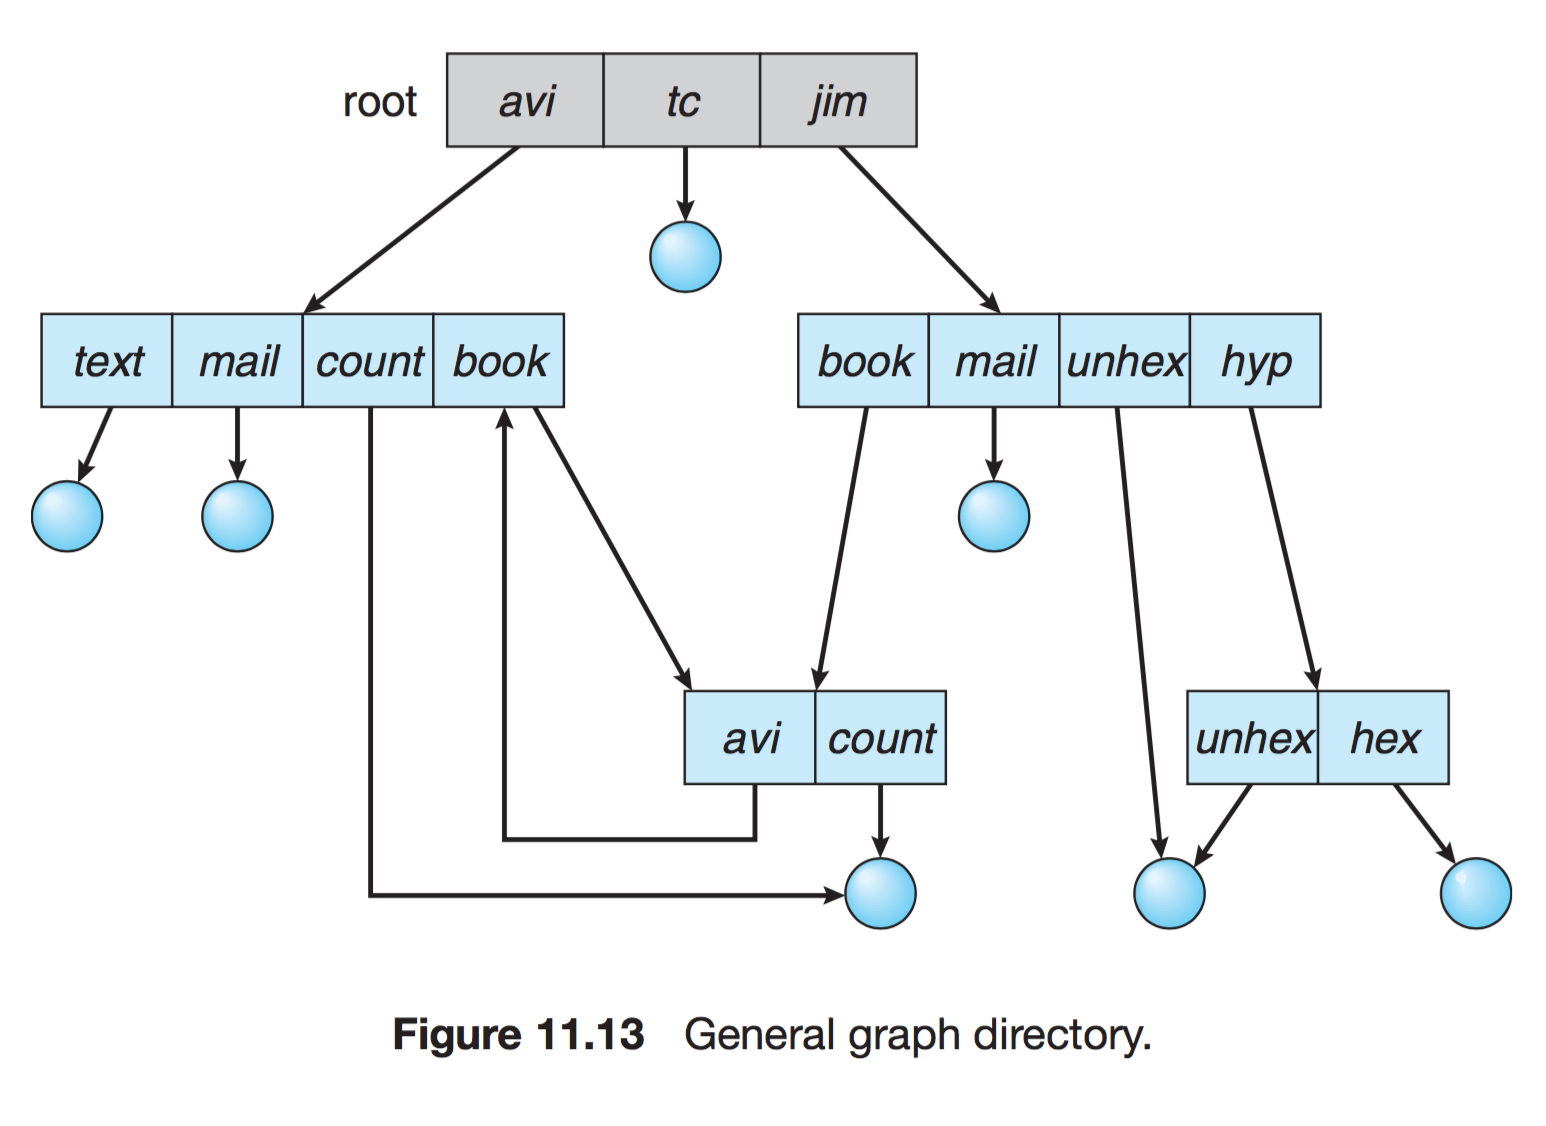
그림 출처: noep 블로그, 파일 시스템 정리 (원출처: Silberschatz 외, Operating System Concepts)
디렉터리 구조 비교
| 구조 | 특징 | 한계 |
|---|---|---|
| 1단계 | 디렉터리 하나에 모든 파일 | 이름이 겹치면 안 됨, 정리 불가 |
| 2단계 | 사용자마다 디렉터리 | 사용자 안에서는 더 못 나눔 |
| 트리 | 디렉터리 안에 디렉터리 | 파일 공유가 어려움 |
| 그래프 | 트리 + 링크로 공유 | 순환을 막거나 정리하는 장치 필요 |
정리
| 개념 | 비전공자 버전 요약 |
|---|---|
| 파일 시스템 | 저장 장치 속 파일을 이름과 폴더로 찾고 관리하게 해 주는 창고 관리 규칙 |
| 메타 영역 | 파일 이름, 위치, 크기, 시간 같은 정보를 적은 관리 대장 |
| 데이터 영역 | 파일의 실제 내용이 저장된 곳 |
| 순차 접근 | 테이프처럼 처음부터 차례대로 읽기 |
| 직접 접근 | 원하는 번호의 블록으로 바로 가서 읽기. 데이터베이스에서 많이 씀 |
| 색인 접근 | 찾아보기(색인)로 위치를 먼저 찾고 바로 가기 |
| 1단계 디렉터리 | 폴더 하나에 모든 파일. 이름이 겹치면 안 됨 |
| 2단계 디렉터리 | 사용자마다 폴더 하나씩 |
| 트리 디렉터리 | 폴더 안에 폴더. 지금 쓰는 대부분의 구조 |
| 그래프 디렉터리 | 링크로 여러 곳에서 공유. 순환을 조심해야 함 |
참고: noep - 파일 시스템