
다익스트라 (Dijkstra) 알고리즘
다익스트라 알고리즘은 한 출발 정점에서 다른 모든 정점까지 가는 최단 거리를 구하는 알고리즘입니다.
한눈에 보기
특정한 정점에서 다른 모든 정점으로 가는 최단 경로를 기록합니다. 간선마다 거리(비용)가 다른 그래프에서 씁니다. 간선 수만 따지는 최단 경로라면 BFS로 충분합니다.
비유하면 동네 지도에서 집으로부터 각 가게까지의 거리를 구하는 일입니다. 아직 확정하지 않은 가게 중 지금까지 알아낸 거리가 가장 짧은 곳을 "여기까지는 이 거리가 최단"이라고 확정합니다. 그리고 그 가게를 거쳐 가면 다른 가게까지 더 빨리 갈 수 있는지 확인해 거리표를 고칩니다. 이것을 모든 가게가 확정될 때까지 반복합니다.
원문은 다익스트라를 "DP를 활용한 최단 경로 탐색 알고리즘"이라고 소개합니다. 한 번 최단 거리를 구한(확정한) 곳은 다시 구할 필요가 없고, 이미 구한 최단 거리를 이용해 다음 정점의 최단 거리를 구한다는 점에서 동적 계획법과 닮았기 때문입니다. 다만 교과서에서는 보통 그리디(탐욕) 알고리즘으로 분류합니다. 매 단계 "지금 가장 가까운 정점"을 골라 바로 확정하는 방식이기 때문입니다.
다익스트라를 구현하려면 두 가지를 저장합니다.
| 저장할 것 | 예시 이름 | 의미 |
|---|---|---|
| 최단 거리 | distance[i] | 시작 정점에서 i까지 지금까지 알아낸 가장 짧은 거리 |
| 방문 여부 | visited[i] | i의 최단 거리가 확정되었는지 |
동작 과정
- 모든 정점의 최단 거리 값을 무한대로 초기화합니다.
- 시작 정점의 최단 거리는 0입니다. 그리고 시작 정점을 방문 처리합니다.
- 시작 정점과 연결된 정점들의 최단 거리 값을 간선 거리로 갱신합니다.
- 방문하지 않은 정점 중 최단 거리가 가장 작은 정점을 찾습니다. (그런 정점이 없으면, 즉 남은 정점에 갈 수 없으면 끝냅니다.)
- 찾은 정점을 방문 처리한 뒤, 그 정점과 연결된 방문하지 않은 정점들에 대해 "그 정점을 거쳐 가는 거리"가 더 짧으면 최단 거리 값을 갱신합니다.
- 모든 정점을 방문할 때까지 4~5번을 반복합니다.
예시 그래프 (무방향, 시작 정점 1)
| 간선 | 1-2 | 1-3 | 1-6 | 2-3 | 2-4 | 3-4 | 3-6 | 4-5 | 5-6 |
|---|---|---|---|---|---|---|---|---|---|
| 거리 | 7 | 9 | 14 | 10 | 15 | 11 | 2 | 6 | 9 |
| 단계 | 방문 처리한 정점 | distance [1, 2, 3, 4, 5, 6] | 설명 |
|---|---|---|---|
| 1~3 | 1 | [0, 7, 9, ∞, ∞, 14] | 1의 이웃 2, 3, 6에 간선 거리 기록 |
| 4~5 | 2 (거리 7) | [0, 7, 9, 22, ∞, 14] | 2를 거치면 4까지 7+15=22. 3은 7+10=17 > 9라 그대로 |
| 4~5 | 3 (거리 9) | [0, 7, 9, 20, ∞, 11] | 3을 거치면 4는 9+11=20 < 22, 6은 9+2=11 < 14로 갱신 |
| 4~5 | 6 (거리 11) | [0, 7, 9, 20, 20, 11] | 6을 거치면 5까지 11+9=20 |
| 4~5 | 4 (거리 20) | [0, 7, 9, 20, 20, 11] | 4를 거치면 5는 20+6=26 > 20이라 그대로 |
| 4~5 | 5 (거리 20) | [0, 7, 9, 20, 20, 11] | 모든 정점 방문 완료 |
1에서 6으로 바로 가면 14지만, 1 → 3 → 6으로 돌아가면 9+2=11로 더 짧습니다. 이렇게 "거쳐 가는 길이 더 짧은 경우"를 찾아 고치는 것이 5번 단계(갱신)입니다.
그림으로 보기
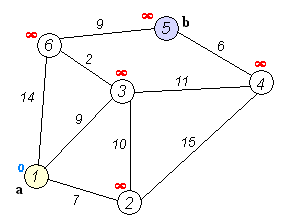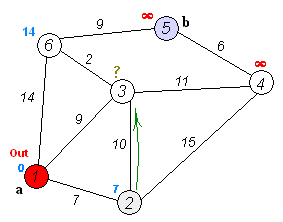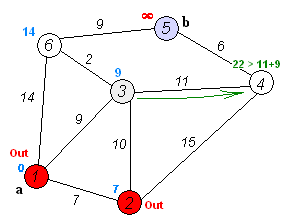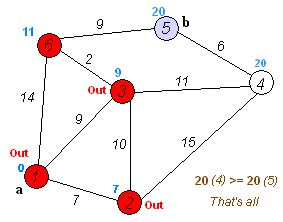
그림 출처: Wikimedia Commons
Python 코드
인접 행렬 버전
원문의 단계별 코드를 그대로 Python으로 옮긴 버전입니다. graph[a][b]에 a와 b 사이 간선 거리를 넣고, 간선이 없으면 None으로 둡니다.
INF = float("inf")


def dijkstra_matrix(graph, start):
    """인접 행렬로 구현한 다익스트라. 정점 번호는 1부터"""
    n = len(graph) - 1
    distance = [INF] * (n + 1)              # 1. 모든 최단 거리를 무한대로
    visited = [False] * (n + 1)

    distance[start] = 0                     # 2. 시작 정점은 0, 방문 처리
    visited[start] = True

    for i in range(1, n + 1):               # 3. 시작 정점의 이웃 거리 채우기
        if not visited[i] and graph[start][i] is not None:
            distance[i] = graph[start][i]

    for _ in range(n - 1):
        min_dist, midx = INF, -1            # 4. 방문 안 한 정점 중 가장 가까운 곳 찾기
        for i in range(1, n + 1):
            if not visited[i] and distance[i] < min_dist:
                min_dist, midx = distance[i], i
        if midx == -1:                      #    더 갈 수 있는 정점이 없으면 끝
            break

        visited[midx] = True                # 5. 확정하고, 그 정점을 거쳐 가는 길로 갱신
        for i in range(1, n + 1):
            if not visited[i] and graph[midx][i] is not None:
                if distance[i] > distance[midx] + graph[midx][i]:
                    distance[i] = distance[midx] + graph[midx][i]

    return distance                         # 6. 4~5를 n-1번 반복한 결과


edges = [(1, 2, 7), (1, 3, 9), (1, 6, 14), (2, 3, 10), (2, 4, 15),
         (3, 4, 11), (3, 6, 2), (4, 5, 6), (5, 6, 9)]
n = 6
graph = [[None] * (n + 1) for _ in range(n + 1)]
for a, b, w in edges:
    graph[a][b] = graph[b][a] = w           # 무방향 그래프

print(dijkstra_matrix(graph, 1)[1:]) # 출력: [0, 7, 9, 20, 20, 11]- 아직 모르는 거리는 무한대(
float("inf"))로 둡니다. 어떤 실제 거리보다도 크므로 첫 비교에서 바로 바뀝니다. - 출발점까지의 거리는 당연히 0이고, 처음부터 확정입니다.
- 출발점과 바로 연결된 정점은 간선 거리가 곧 현재까지 알아낸 거리입니다.
- 확정되지 않은 정점 중 거리가 가장 작은 것을 고릅니다. 남은 정점이 모두 무한대(갈 수 없음)면
midx가 -1로 남으므로 멈춥니다. - 고른 정점을 확정하고, 그 정점을 거쳐 가는 거리(
distance[midx] + 간선)가 기존 값보다 짧은 이웃을 갱신합니다. - 출발점을 뺀 n-1개 정점을 하나씩 확정하면 끝납니다. 끝까지 무한대인 정점은 출발점에서 갈 수 없는 정점입니다.
우선순위 큐(힙) 버전
4번 단계에서 "가장 가까운 정점"을 매번 전체를 훑어 찾으면 느립니다. 최소 힙(Python heapq)에 (거리, 정점)을 넣어 두면 가장 가까운 정점을 O(log V)에 꺼낼 수 있습니다. 그래프는 인접 리스트(adj[v] = [(이웃, 거리), ...])로 저장합니다.
import heapq

INF = float("inf")


def dijkstra_heap(adj, start):
    """인접 리스트 + 최소 힙으로 구현한 다익스트라"""
    distance = [INF] * len(adj)
    distance[start] = 0
    pq = [(0, start)]                       # 1. (거리, 정점)을 최소 힙에 넣기

    while pq:
        dist, v = heapq.heappop(pq)         # 2. 지금까지 가장 가까운 정점 꺼내기
        if dist > distance[v]:              # 3. 이미 더 짧은 거리로 확정된 옛 기록은 건너뛰기
            continue
        for nxt, w in adj[v]:               # 4. 이웃 거리 갱신, 줄어들면 힙에 넣기
            nd = dist + w
            if nd < distance[nxt]:
                distance[nxt] = nd
                heapq.heappush(pq, (nd, nxt))

    return distance


adj = [[] for _ in range(n + 1)]
for a, b, w in edges:
    adj[a].append((b, w))
    adj[b].append((a, w))

print(dijkstra_heap(adj, 1)[1:]) # 출력: [0, 7, 9, 20, 20, 11]- 힙은 넣은 것 중 가장 작은 값을 빠르게 꺼내 주는 구조입니다. 튜플은 첫 값(거리)으로 비교되므로 거리가 가장 짧은 정점이 먼저 나옵니다.
- 꺼낸 정점이 "방문하지 않은 정점 중 가장 가까운 정점"입니다. 인접 행렬 버전의 4번 단계를 힙이 대신합니다.
- 같은 정점이 거리가 줄어들 때마다 힙에 여러 번 들어갈 수 있습니다. 꺼낸 거리가 이미 기록된 최단 거리보다 크면 낡은 기록이므로 버립니다. 이것이
visited역할을 합니다. - 실제로 연결된 이웃만 확인하고, 더 짧아진 경우에만 갱신해서 힙에 넣습니다.
시간복잡도와 공간복잡도
V는 정점 수, E는 간선 수입니다.
| 구현 방법 | 시간복잡도 | 이유 |
|---|---|---|
| 인접 행렬 + 선형 탐색 | O(V²) | 정점 V개를 확정할 때마다 V개를 훑어 최솟값을 찾고, V개 이웃을 확인 |
| 인접 리스트 + 우선순위 큐(힙) | O((V + E) log V) | 간선마다 힙에 넣기/꺼내기가 최대 한 번씩, 한 번에 O(log V) |
- 공간복잡도: 거리·방문 배열 O(V). 그래프 저장은 인접 행렬 O(V²), 인접 리스트 O(V + E). 힙 버전은 힙에 최대 O(E)개가 쌓일 수 있습니다.
- 간선이 적은 그래프(대부분의 문제)에서는 힙 버전이 훨씬 빠릅니다. 반대로 거의 모든 정점끼리 연결된 빽빽한 그래프(E ≈ V²)라면 인접 행렬 버전이 더 나을 수도 있습니다. 복잡도 표기는 시간 복잡도 글을 참고하세요.
다익스트라 적용 시 알아야 할 점
- 인접 행렬로 구현하면 시간복잡도는 O(V²)입니다.
- 인접 리스트와 우선순위 큐(힙)로 구현하면 O((V + E) log V)입니다. 선형 탐색으로 시간 초과가 나는 문제는 이 방법으로 접근해야 합니다.
- 간선의 거리가 음수가 아닐 때(0 이상)만 쓸 수 있습니다. 한 번 확정한 정점은 다시 보지 않는데, 음수 간선이 있으면 나중에 "돌아가는 길"이 더 짧아질 수 있어서 확정한 값이 틀리게 됩니다. 음수 간선이 있으면 벨만-포드 같은 다른 알고리즘을 씁니다.
- 인접 행렬에서 "간선 없음"을 0으로 표시하면 거리 0인 간선과 구분이 안 됩니다. 위 코드처럼
None(또는 무한대)으로 표시하는 것이 안전합니다.
정리
| 개념 | 비전공자 버전 요약 |
|---|---|
| 다익스트라 | 아직 확정 안 한 곳 중 가장 가까운 곳부터 확정하고, 그곳을 거쳐 가는 길로 거리표 고치기 |
| 갱신(완화) | "여기를 거쳐 가면 더 짧네?" 싶으면 거리표 숫자를 줄이기 |
| 우선순위 큐 | 가장 가까운 곳을 매번 전부 훑지 않고 바로 꺼내 주는 도구 |
| 제약 | 거리가 음수인 길이 있으면 쓸 수 없음 |