
힙 정렬 (Heap Sort)
힙(Heap) 자료구조로 가장 큰 값을 하나씩 뽑아 배열 뒤쪽부터 채워 나가는 정렬입니다.
한눈에 보기
- 완전 이진 트리를 기본으로 하는 힙(Heap) 자료구조를 기반으로 한 정렬 방식입니다.
- 완전 이진 트리 = 위층부터 빈칸 없이 채우고, 마지막 층은 왼쪽부터 차례대로 채우는 이진 트리입니다. 새 노드를 넣을 때도 항상 왼쪽부터 차례대로 추가합니다.
- 최대 힙 = 부모가 항상 자식보다 크거나 같은 힙입니다. 그래서 루트(맨 위)에는 늘 가장 큰 값이 있습니다. 반대로 부모가 더 작은 쪽은 최소 힙입니다.
- 비유하면, 운동회 토너먼트에서 1등을 뽑아 시상대 맨 끝자리에 세우고, 남은 사람들끼리 다시 짧게 겨뤄 다음 1등을 뽑는 일을 반복하는 것과 같습니다.
- 값끼리 크기를 비교하는 비교 정렬입니다.
- 불안정 정렬입니다. 루트와 맨 끝 원소를 멀리 떨어진 자리끼리 바꾸기 때문에, 값이 같은 원소의 순서가 바뀔 수 있습니다.
- 배열 안에서 자리만 바꾸므로 제자리 정렬(in-place) 입니다.
배열로 트리 표현하기
완전 이진 트리는 빈칸이 없어서 배열에 층 순서대로 담을 수 있습니다. 인덱스 i인 노드의 가족은 이렇게 계산합니다.
| 관계 | 인덱스 |
|---|---|
| 왼쪽 자식 | i * 2 + 1 |
| 오른쪽 자식 | i * 2 + 2 |
| 부모 | (i - 1) // 2 |
예를 들어 배열 [11, 9, 2, 7, 4]는 이런 트리입니다.
| 층 | 노드 (인덱스: 값) |
|---|---|
| 1층 (루트) | 0: 11 |
| 2층 | 1: 9, 2: 2 |
| 3층 | 3: 7, 4: 4 (둘 다 9의 자식) |
동작 과정
- 배열 전체로 최대 힙을 만듭니다.
- 현재 힙의 루트에는 가장 큰 값이 있습니다. 루트의 값을 힙의 마지막 요소와 바꾼 뒤, 힙의 크기를 하나 줄입니다. (맨 뒤로 간 값은 정렬이 끝난 값입니다.)
- 줄어든 힙으로 다시 최대 힙을 만들고, 힙의 크기가 1보다 크면 2번부터 반복합니다.
이렇게 최댓값을 하나씩 뽑아내면서 정렬하는 것이 힙 정렬입니다.
예시 배열 [7, 4, 2, 9, 11]로 먼저 최대 힙을 만듭니다. 자식이 있는 마지막 부모(인덱스 1)부터 루트(인덱스 0)까지 거꾸로 내려가며 정리합니다.
| 단계 | 배열 상태 | 설명 |
|---|---|---|
| 시작 | [7, 4, 2, 9, 11] | 아직 힙이 아님 |
| 인덱스 1 정리 | [7, 11, 2, 9, 4] | 4의 자식 9, 11 중 큰 11과 교환 |
| 인덱스 0 정리 | [11, 7, 2, 9, 4] | 7의 자식 11, 2 중 큰 11과 교환 |
| 이어서 내려가기 | [11, 9, 2, 7, 4] | 내려간 7의 자식 9, 4 중 큰 9와 교환 |
| 최대 힙 완성 | [11, 9, 2, 7, 4] | 루트 11이 최댓값 |
이제 최댓값을 하나씩 뒤로 보냅니다. 한 회전은 "루트를 마지막 노드로 대체한 뒤 다시 최대 힙을 구성"하는 일입니다. 아래 그림은 다른 예시 힙 [11, 5, 8, 3, 4]에서 루트 11을 마지막 노드 4로 대체하는 모습입니다.
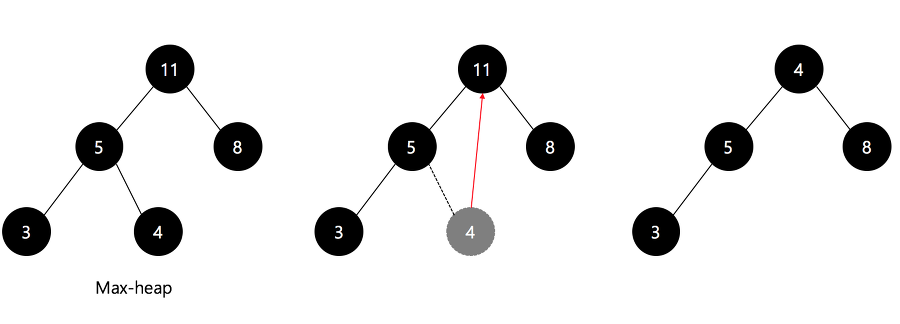
루트에 올라간 4는 자식 5, 8보다 작으므로, 더 큰 자식 8과 자리를 바꿔 다시 최대 힙을 만듭니다.
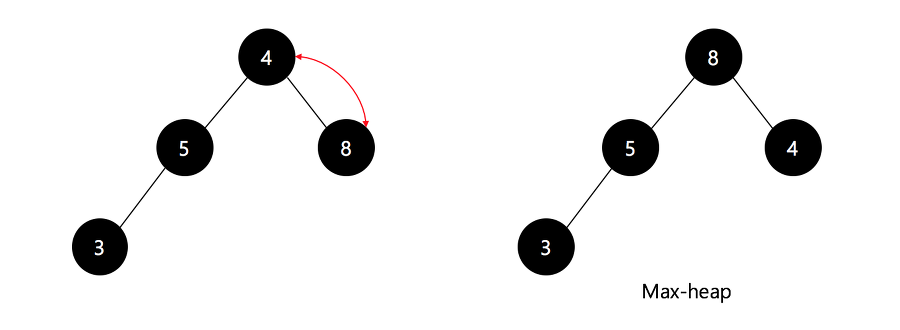
그림 출처: gyoogle/tech-interview-for-developer 힙 소트
아래 표에서 | 뒤쪽은 정렬이 끝난 부분입니다.
| 회전 | 루트와 끝 교환 후 | 다시 최대 힙 구성 후 | 설명 |
|---|---|---|---|
| 1 | [4, 9, 2, 7 | 11] | [9, 7, 2, 4 | 11] | 11을 맨 뒤로. 루트 4를 9, 7과 차례로 교환 |
| 2 | [4, 7, 2 | 9, 11] | [7, 4, 2 | 9, 11] | 9를 뒤로. 루트 4를 7과 교환 |
| 3 | [2, 4 | 7, 9, 11] | [4, 2 | 7, 9, 11] | 7을 뒤로. 루트 2를 4와 교환 |
| 4 | [2 | 4, 7, 9, 11] | [2 | 4, 7, 9, 11] | 4를 뒤로. 힙 크기가 1이 되어 끝 |
결과: [2, 4, 7, 9, 11]
그림으로 보기
아래 애니메이션은 배열로 최대 힙을 만든 뒤, 루트(최댓값)를 배열 끝으로 보내고 남은 힙을 다시 정리하는 과정을 반복합니다. 위쪽 배열에서 검게 칠해지는 칸이 정렬이 끝난 부분입니다.
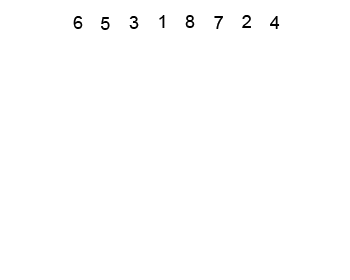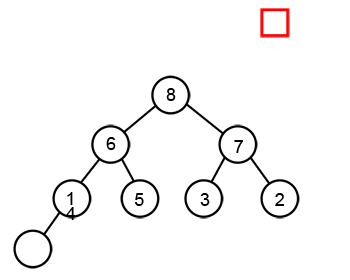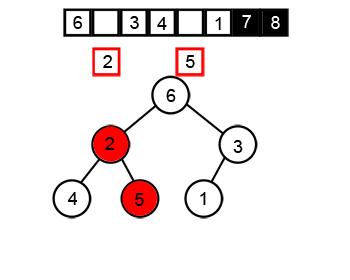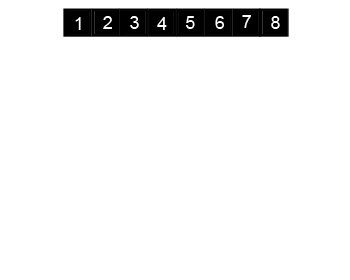
그림 출처: Wikimedia Commons (CC BY-SA 3.0, Swfung8)
Python 코드
def heapify(array, n, i):
    # 1. 부모(i)와 두 자식 중 가장 큰 값의 위치를 찾습니다
    p = i
    l = i * 2 + 1
    r = i * 2 + 2

    if l < n and array[p] < array[l]:   # 왼쪽 자식이 더 크면
        p = l
    if r < n and array[p] < array[r]:   # 오른쪽 자식이 더 크면
        p = r

    # 2. 자식이 더 크면 자리를 바꾸고, 내려간 자리에서 다시 확인합니다
    if i != p:
        array[p], array[i] = array[i], array[p]
        heapify(array, n, p)


def heap_sort(array):
    n = len(array)

    # 3. 최대 힙 만들기: 자식이 있는 마지막 부모(n//2 - 1)부터 루트(0)까지
    for i in range(n // 2 - 1, -1, -1):
        heapify(array, n, i)

    # 4. 루트(최댓값)를 맨 뒤로 보내고, 남은 앞부분으로 다시 최대 힙 만들기
    for i in range(n - 1, 0, -1):
        array[0], array[i] = array[i], array[0]
        heapify(array, i, 0)


array = [230, 10, 60, 550, 40, 220, 20]
heap_sort(array)
print(array)
# 출력: [10, 20, 40, 60, 220, 230, 550]heapify는 "i번 노드 아래를 최대 힙으로 정리"하는 함수입니다.n은 지금 힙으로 쓰는 앞부분의 길이이고,n보다 뒤는 이미 정렬된 칸이라 건드리지 않습니다. 부모, 왼쪽 자식, 오른쪽 자식 중 가장 큰 값의 위치를p에 담습니다.- 부모보다 큰 자식이 있으면(
i != p) 둘을 바꿉니다. 내려간 값이 새 자리에서도 자식보다 작을 수 있으므로, 다시 최대 힙이 될 때까지 부모와 자식을 바꾸며 재귀로 계속 내려갑니다. - 첫 번째
heapify반복입니다. 아래 설명 참고. - 두 번째
heapify반복입니다. 아래 설명 참고.
첫 번째 heapify: 일반 배열을 힙으로 만들기
- 일반 배열을 최대 힙으로 구성하는 역할입니다.
- 아래쪽 부모부터 위로 올라가며, 부모와 자식 노드를 비교합니다.
- 왜
n // 2 - 1부터 0까지 도나요? 인덱스i의 왼쪽 자식은i * 2 + 1, 오른쪽 자식은i * 2 + 2입니다. 그래서 자식이 하나라도 있는 마지막 노드는n // 2 - 1번이고, 그 뒤의 노드는 모두 자식이 없는 잎(leaf)입니다. 잎은 혼자서 이미 힙이므로 정리할 필요가 없습니다. 아래 부모부터 정리해야 위 부모를 정리할 때 양쪽 자식 아래가 이미 힙이라는 조건이 성립합니다.
두 번째 heapify: 하나 꺼낸 뒤 다시 힙 만들기
- 루트(최댓값)를 끝으로 보내 요소가 하나 빠진 뒤, 다시 최대 힙을 구성하기 위한 것입니다.
- 새로 루트에 올라온 값만 제자리가 아니므로, 루트를 기준으로 진행합니다 (최댓값을 꺼내는 extract 연산 처리).
불안정 정렬인 이유 예시
값이 같은 두 5를 5a, 5b로 구분해 [5a, 5b, 3]을 정렬하면, 루트 5a가 먼저 맨 뒤로 가서 결과가 [3, 5b, 5a]가 됩니다. 원래 앞에 있던 5a가 뒤로 가 버렸으므로 안정 정렬이 아닙니다.
시간복잡도와 공간복잡도
| 경우 | 시간복잡도 |
|---|---|
| 최선 | Ω(n log n) |
| 평균 | Θ(n log n) |
| 최악 | O(n log n) |
- 처음 최대 힙을 만드는 데 O(n), 그 뒤 최댓값을 n - 1번 꺼낼 때마다 트리 높이만큼(log n) 내려가며 정리하므로 전체 O(n log n)입니다. 입력 모양과 거의 상관없이 일정합니다. (모든 값이 같은 특수한 경우만 교환이 일어나지 않아 O(n)입니다.)
- 공간복잡도: 배열 안에서 자리만 바꾸므로 추가 메모리 O(1) 입니다. 단, 위 코드처럼
heapify를 재귀로 쓰면 호출 스택이 O(log n)만큼 쌓이고, 반복문으로 바꾸면 O(1)이 됩니다.
힙 정렬이 쓰이는 곳
퀵 정렬과 병합 정렬의 성능이 좋기 때문에 힙 정렬 자체의 사용 빈도가 높지는 않습니다. 하지만 힙 자료구조는 많이 활용되고, 이때 함께 따라오는 개념이 힙 정렬입니다.
힙 정렬이 유용할 때
- 가장 크거나 가장 작은 값을 구할 때: 최대 힙이나 최소 힙의 루트 값이기 때문에, 한 번의 힙 구성만으로 구할 수 있습니다.
- 최대 k만큼 떨어진 요소들을 정렬할 때: 모든 원소가 정렬된 위치에서 최대 k칸 안에 있는 배열이라면, 크기 k + 1짜리 최소 힙으로 O(n log k)에 정렬할 수 있습니다. 삽입 정렬(O(nk))보다 더 개선된 결과입니다.
import heapq

def sort_k_sorted(arr, k):
    # 1. 앞의 k+1개로 최소 힙을 만듭니다 (가장 작은 값은 이 안에 반드시 있음)
    heap = arr[:k + 1]
    heapq.heapify(heap)
    result = []
    # 2. 하나 꺼낼 때마다 다음 값을 하나 넣습니다 → 힙 크기는 늘 k+1 이하
    for x in arr[k + 1:]:
        result.append(heapq.heappushpop(heap, x))
    # 3. 남은 값을 차례로 꺼냅니다
    while heap:
        result.append(heapq.heappop(heap))
    return result


print(sort_k_sorted([2, 1, 4, 3, 6, 5, 8, 7], 1))
# 출력: [1, 2, 3, 4, 5, 6, 7, 8]- 첫 번째 원소의 정답 자리는 0번이고, 이 값은 원래 0 ~ k번 칸 어딘가에 있습니다. 그래서 앞의 k + 1개만 힙에 넣어도 가장 작은 값을 찾을 수 있습니다.
heappushpop은 새 값을 넣고 가장 작은 값을 꺼냅니다. 힙 크기가 k + 1로 작게 유지되므로 한 번에 O(log k)입니다.- 입력이 다 떨어지면 힙에 남은 값을 작은 순서대로 꺼내 붙입니다.
정리
| 개념 | 비전공자 버전 요약 |
|---|---|
| 힙 정렬 | 1등을 뽑아 맨 뒤에 세우고, 남은 사람끼리 다시 1등 뽑기 반복 |
| 완전 이진 트리 | 위층부터, 마지막 층은 왼쪽부터 빈칸 없이 채운 트리 |
| 최대 힙 | 부모가 항상 자식보다 큰 피라미드. 맨 위가 최댓값 |
| heapify | 자리가 틀린 값을 자식과 바꿔 가며 아래로 내려보내 힙 규칙 복구 |
| 불안정 정렬 | 같은 값끼리 원래 순서가 바뀔 수 있음 |