
기수 정렬 (Radix Sort)
숫자끼리 크기를 비교하지 않고, 1의 자리, 10의 자리, 100의 자리 순서로 자릿수별로 나눠 담으며 정렬하는 방법입니다.
한눈에 보기
- 기수(Radix) 는 데이터를 구성하는 기본 요소, 즉 진법의 밑(10진수라면 0 ~ 9)을 말합니다. 기수 정렬은 이 기본 요소(자릿수)를 이용해 정렬을 진행합니다.
- 비유하면, 우체국에서 편지를 우편번호 끝자리 기준으로 0 ~ 9번 상자에 나눠 담고, 상자 순서대로 다시 모은 뒤, 이번엔 그 앞자리 기준으로 다시 나눠 담는 일을 반복하는 것과 같습니다. 모든 자리를 다 돌면 편지가 번호 순서대로 정렬됩니다.
- 원소끼리 크기를 비교하지 않는 비교 아닌 정렬(non-comparison sort) 입니다.
- 자릿수마다 안정적인 계수 정렬을 쓰기 때문에 전체도 안정 정렬입니다.
- 중간 결과를 담을 버퍼(bucket) 공간이 필요하므로 제자리 정렬이 아닙니다.
비교 정렬(Comparison Sort)의 한계
N개 원소를 줄 세우는 방법은 모두 N!가지입니다. 비교 정렬은 "a < b인가?"라는 예/아니오 질문을 반복하므로, 질문 과정을 트리(결정 트리)로 그리면 높이가 h일 때 끝(말단 노드)은 최대 2^h개입니다.
- 모든 경우를 구분하려면 말단 노드가 N! 개 이상이어야 하므로 2^h ≥ N! 을 만족해야 합니다.
- 양쪽에 log를 씌우면 h ≥ log₂(N!) 이고, log₂(N!)은 n log n과 같은 크기(Θ(n log n))입니다.
- h는 최악의 경우 비교 횟수, 즉 비교 정렬의 시간복잡도입니다. 그래서 어떤 비교 정렬도 최악의 경우 Ω(n log n)보다 빠를 수 없습니다.
이 O(n log n)의 벽을 넘는 방법은 비교를 하지 않는 것입니다. 기수 정렬과 계수 정렬이 그런 방법입니다.
계수 정렬의 약점 보완
- 계수 정렬은 입력의 최댓값 k만큼 큰 배열이 필요해서, 큰 수가 하나만 섞여도 비효율적입니다.
- 기수 정렬은 이를 개선하기 위해 자릿수 하나씩 계수 정렬을 합니다. 한 자리의 값은 0 ~ 9뿐이라서, 카운트 배열은 항상 크기 10(최댓값 9)이면 충분합니다.
동작 과정
- 가장 큰 값을 찾아 몇 자리까지 봐야 하는지 정합니다.
- 1의 자리를 기준으로 안정적인 계수 정렬을 합니다.
- 10의 자리, 100의 자리 ... 순서로 최댓값의 자릿수만큼 2번을 반복합니다.
- 마지막 자리까지 끝나면 전체가 정렬됩니다.
예시 배열 [170, 45, 75, 90, 802, 24, 2, 66] (최댓값 802 → 3자리):
| 회전 | 기준 자리 | 배열 상태 | 설명 |
|---|---|---|---|
| 시작 | - | [170, 45, 75, 90, 802, 24, 2, 66] | 정렬 전 |
| 1 | 1의 자리 | [170, 90, 802, 2, 24, 45, 75, 66] | 끝자리 0, 0, 2, 2, 4, 5, 5, 6 순. 170과 90처럼 끝자리가 같으면 원래 순서 유지 |
| 2 | 10의 자리 | [802, 2, 24, 45, 66, 170, 75, 90] | 802와 2는 10의 자리가 0이라 맨 앞. 이전 순서(802 → 2) 그대로 유지 |
| 3 | 100의 자리 | [2, 24, 45, 66, 75, 90, 170, 802] | 100의 자리 0인 것들이 앞, 1(170), 8(802) 순. 정렬 완료 |
그림으로 보기
아래 애니메이션은 숫자를 자릿값(0 ~ 9)에 따라 열 개의 상자(버킷)에 나눠 담았다가, 0번 상자부터 차례로 다시 꺼내는 일을 1의 자리, 10의 자리, 100의 자리 순서로 반복합니다. 그림의 个位, 十位, 百位는 각각 1의 자리, 10의 자리, 100의 자리라는 뜻입니다.
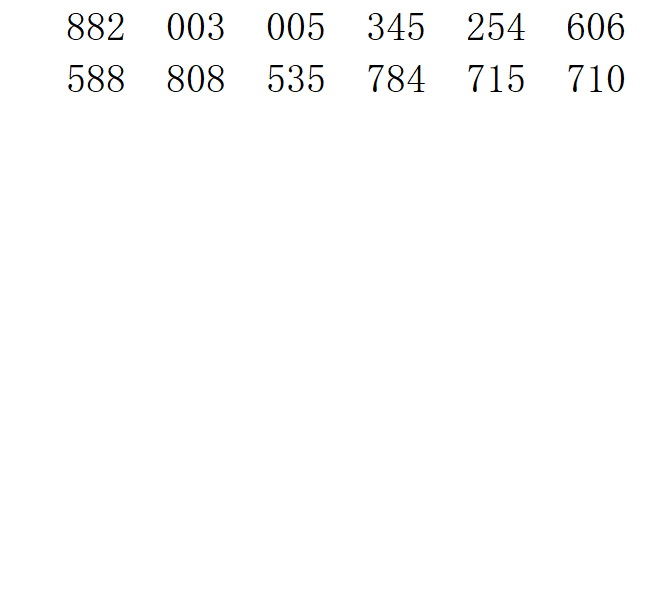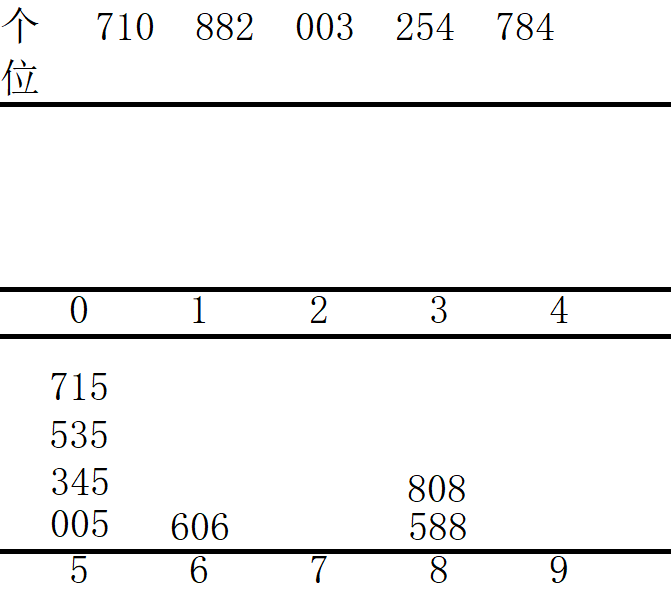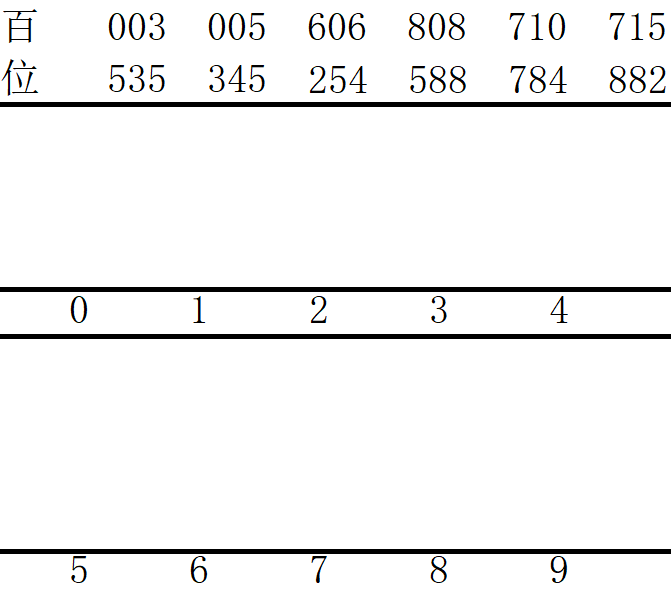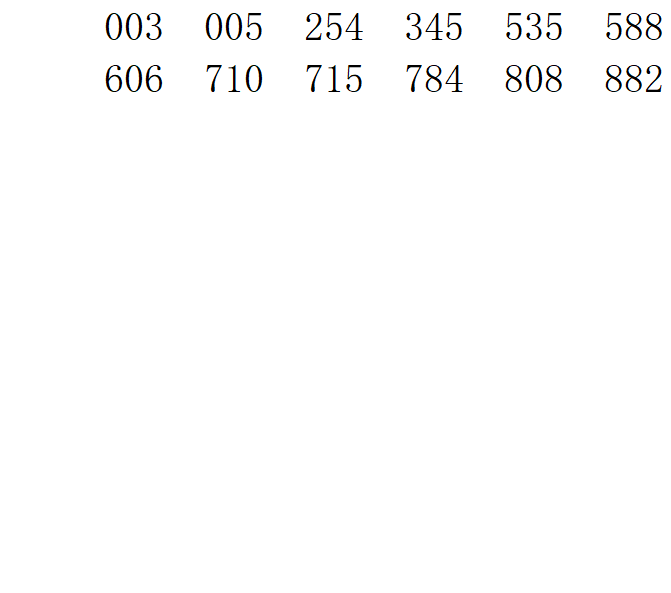
그림 출처: Wikimedia Commons (CC BY-SA 4.0, GnolizX)
Python 코드
python
def counting_sort_by_digit(arr, exp):
    n = len(arr)
    buffer = [0] * n
    count = [0] * 10

    # 1. 현재 자리(exp)의 숫자가 몇 번 나오는지 셉니다
    for i in range(n):
        count[(arr[i] // exp) % 10] += 1

    # 2. 누적합으로 바꿉니다 → 각 숫자가 들어갈 마지막 칸 번호
    for i in range(1, 10):
        count[i] += count[i - 1]

    # 3. 뒤에서부터 돌며 제자리에 넣습니다 (뒤에서부터라서 안정 정렬)
    for i in range(n - 1, -1, -1):
        digit = (arr[i] // exp) % 10
        buffer[count[digit] - 1] = arr[i]
        count[digit] -= 1

    # 4. 정렬된 결과를 원래 배열에 복사합니다
    for i in range(n):
        arr[i] = buffer[i]


def radix_sort(arr):
    if not arr:
        return
    # 5. 최댓값의 자릿수만큼만 돌면 됩니다
    m = max(arr)

    # 6. 1의 자리 → 10의 자리 → 100의 자리 ... 순서로 정렬 (LSD)
    exp = 1
    while m // exp > 0:
        counting_sort_by_digit(arr, exp)
        exp *= 10


arr = [170, 45, 75, 90, 802, 24, 2, 66]
radix_sort(arr)
print(arr)
# 출력: [2, 24, 45, 66, 75, 90, 170, 802]exp는 1, 10, 100 ... 입니다.(arr[i] // exp) % 10은 지금 보는 자리의 숫자입니다. 예를 들어 802에서exp = 10이면80 % 10 = 0입니다. 이 숫자가 몇 번 나오는지count에 셉니다.count를 누적합으로 바꾸면count[d]는 "자리 숫자가 d 이하인 원소의 개수", 즉 d인 원소가 들어갈 마지막 칸 번호 + 1이 됩니다.- 배열을 뒤에서부터 돌며
buffer의 제자리에 넣고 칸 번호를 하나 줄입니다. 뒤에서부터 넣어야 자리 숫자가 같은 원소끼리 원래 순서가 유지됩니다(안정 정렬). 이게 기수 정렬이 제대로 동작하는 핵심입니다. - 이번 자리 기준으로 정렬된
buffer를 원래 배열에 옮깁니다. - 최댓값의 자릿수만큼만 반복하면 됩니다.
m // exp가 0이 되면 모든 숫자가exp보다 작다는 뜻이므로 더 볼 자리가 없습니다. 이 코드는 0 이상의 정수를 대상으로 합니다. 음수가 섞여 있으면 음수와 양수를 나눠 따로 정렬하거나, 모든 값에 최솟값만큼 더해 0 이상으로 옮긴 뒤 정렬하면 됩니다.
시간복잡도와 공간복잡도
| 경우 | 시간복잡도 |
|---|---|
| 최선 | O(d × (n + b)) |
| 평균 | O(d × (n + b)) |
| 최악 | O(d × (n + b)) |
- d는 정렬할 숫자의 자릿수, b는 기수(진법의 밑)로 10진수라면 10입니다. 계수 정렬의 k 자리에 해당하지만 최댓값과 상관없이 b로 고정됩니다. (계수 정렬은 O(n + k)로 배열의 최댓값 k에 영향을 받습니다.)
- 자리 하나마다 n개를 세고(n) 카운트 배열을 훑으므로(b) 한 회전이 O(n + b)이고, 이를 d번 반복합니다. d와 b가 작은 상수라면 사실상 O(n)입니다.
- 공간복잡도: 추가 메모리 O(n + b) 입니다. 중간 결과를 담을
buffer(n)와 카운트 배열(b)이 필요합니다.
장점과 단점
장점
- 비교를 하지 않아서 자릿수가 적으면 O(n log n)보다 빠릅니다.
- 정수뿐 아니라 문자열처럼 "자리"로 나눌 수 있는 데이터도 정렬할 수 있습니다 (문자 하나를 한 자리로 봄).
- 안정 정렬입니다.
단점
- 자릿수 개념이 없는 데이터는 그대로 정렬할 수 없습니다. 예를 들어 부동 소수점 수는 10진 자릿수로 바로 나눌 수 없어서, 비트 표현을 정렬 가능한 정수로 바꾸는 추가 작업이 필요합니다.
- 중간 결과를 저장할 bucket(버퍼) 공간이 필요합니다.
면접 질문: 왜 낮은 자릿수부터 정렬하나요?
MSD(Most-Significant-Digit)와 LSD(Least-Significant-Digit)를 비교하라는 질문입니다.
- MSD: 가장 큰 자릿수부터 계수 정렬하는 방식
- LSD: 가장 낮은 자릿수부터 계수 정렬하는 방식
즉, 둘 다 가능합니다. LSD가 동작하는 이유는 각 회전이 안정 정렬이기 때문입니다. 높은 자리가 같은 값끼리는 앞 회전(낮은 자리)에서 만든 순서가 그대로 남아 있어서, 마지막 회전이 끝나면 전체가 정렬됩니다.
| 비교 | LSD | MSD |
|---|---|---|
| 보는 자릿수 | 1600000과 1을 비교할 때도 자릿수 개수만큼 전부 따져야 함 | 앞자리에서 이미 갈리면 마지막 자리까지 볼 필요 없음 |
| 중간 결과 | 중간에는 정렬 결과를 알 수 없음 (예: 10004와 70002는 마지막 회전에서야 순서가 정해짐) | 중간에 중요한 숫자(앞자리)로 순서를 알 수 있어 시간을 줄일 수 있음 |
| 추가 비용 | 없음 | 그룹별로 정렬이 끝났는지 확인하는 과정이 필요하고, 그 때문에 메모리를 더 씀 |
| 일관성 | 알고리즘이 일관됨 (분기 없는 Branch Free 알고리즘) | 그룹마다 다르게 처리해야 해서 일관되지 못함 |
| 속도 | 자릿수가 정해진 경우 좀 더 빠를 수 있음 | 앞자리에서 빨리 갈리는 데이터에 유리 |
그래서 기수 정렬이라고 하면 주로 LSD를 말합니다.
정리
| 개념 | 비전공자 버전 요약 |
|---|---|
| 기수 정렬 | 끝자리부터 0 ~ 9번 상자에 나눠 담고 모으기를 자릿수만큼 반복 |
| 비교 정렬의 한계 | 크기 비교만으로는 n log n보다 빨라질 수 없음 |
| LSD | 낮은 자리부터. 단순하고 일관돼서 주로 이 방식을 씀 |
| MSD | 높은 자리부터. 앞자리에서 갈리면 일찍 끝낼 수 있음 |
| 안정성 | 자리마다 안정 정렬을 써야 앞 회전의 순서가 지켜짐 |