
병합 정렬 (Merge Sort)
배열을 절반씩 끝까지 쪼갠 뒤, 작은 조각들을 순서대로 합치면서 정렬하는 방법입니다.
한눈에 보기
- 합병 정렬이라고도 부르며, 분할 정복 방법으로 구현합니다.
- 분할 정복 = 큰 문제를 작은 문제 단위로 쪼개면서 해결해 나가는 방식입니다.
- 비유하면, 뒤섞인 시험지 100장을 혼자 정렬하기 어려우니 둘로 나눠 친구에게 맡기고, 친구도 또 반으로 나눠 맡기는 식입니다. 한 장만 남으면 이미 정렬된 것이니, 이제 정렬된 묶음 두 개를 맨 위 장끼리 비교하며 한 묶음으로 합치기만 하면 됩니다.
- 빠른 정렬로 분류되며, 퀵 정렬과 함께 많이 언급됩니다.
- 값끼리 크기를 비교해서 정렬하는 비교 정렬입니다.
- 퀵 정렬과는 반대로 안정 정렬입니다. 값이 같은 원소끼리는 원래 순서가 그대로 유지됩니다.
- 합칠 때 임시 배열이 필요하므로 제자리 정렬(in-place)이 아닙니다.
동작 과정
요소를 쪼갠 후, 다시 합병시키면서 정렬해 나가는 방식입니다. 쪼개는 방식은 퀵 정렬과 비슷합니다.
- 배열을 가운데(
mid)에서 왼쪽 절반, 오른쪽 절반으로 나눕니다. - 조각의 길이가 1이 될 때까지 계속 나눕니다. 길이 1인 조각은 이미 정렬된 상태입니다.
- 정렬된 두 조각을 맨 앞끼리 비교해서 작은 값부터 꺼내 하나로 합칩니다(
merge). - 전체가 한 덩어리가 될 때까지 합치기를 반복합니다.
예시 배열 [6, 5, 3, 1, 8, 7, 2, 4]:
| 단계 | 배열 상태 | 설명 |
|---|---|---|
| 시작 | [6, 5, 3, 1, 8, 7, 2, 4] | 정렬 전 |
| 나누기 1 | [6, 5, 3, 1] [8, 7, 2, 4] | 절반으로 나눔 |
| 나누기 2 | [6, 5] [3, 1] [8, 7] [2, 4] | 다시 절반으로 |
| 나누기 3 | [6] [5] [3] [1] [8] [7] [2] [4] | 길이 1이 되면 멈춤 |
| 합치기 1 | [5, 6] [1, 3] [7, 8] [2, 4] | 두 개씩 비교하며 합침 |
| 합치기 2 | [1, 3, 5, 6] [2, 4, 7, 8] | 네 개씩 합침 |
| 합치기 3 | [1, 2, 3, 4, 5, 6, 7, 8] | 정렬 완료 |
마지막 합치기에서 merge가 하는 일을 자세히 보면 다음과 같습니다. 두 조각이 이미 각각 정렬되어 있기 때문에, 맨 앞끼리만 순서대로 비교하면 됩니다.
| 비교 | 왼쪽 [1, 3, 5, 6] | 오른쪽 [2, 4, 7, 8] | 결과에 넣은 값 |
|---|---|---|---|
| 1 | 1 | 2 | 1 |
| 2 | 3 | 2 | 2 |
| 3 | 3 | 4 | 3 |
| 4 | 5 | 4 | 4 |
| 5 | 5 | 7 | 5 |
| 6 | 6 | 7 | 6 |
| 끝 | (비었음) | 7, 8 | 남은 7, 8을 그대로 붙임 |
퀵 정렬과의 차이점
- 퀵 정렬: 먼저 피벗을 기준으로 정렬(
partition) → 영역을 쪼갬(quickSort) - 병합 정렬: 먼저 영역을 쪼갤 수 있을 만큼 쪼갬(
mergeSort) → 합치면서 정렬(merge)
즉, 퀵 정렬은 "나누기 전에" 일을 하고, 병합 정렬은 "나눈 뒤 합치면서" 일을 합니다. 그래서 병합 정렬의 핵심은 merge() 함수입니다.
그림으로 보기
아래 그림은 [38, 27, 43, 3, 9, 82, 10]을 정렬하는 모습입니다. 빨간 화살표가 쪼개는 단계, 초록 화살표가 정렬하며 합치는 단계입니다.
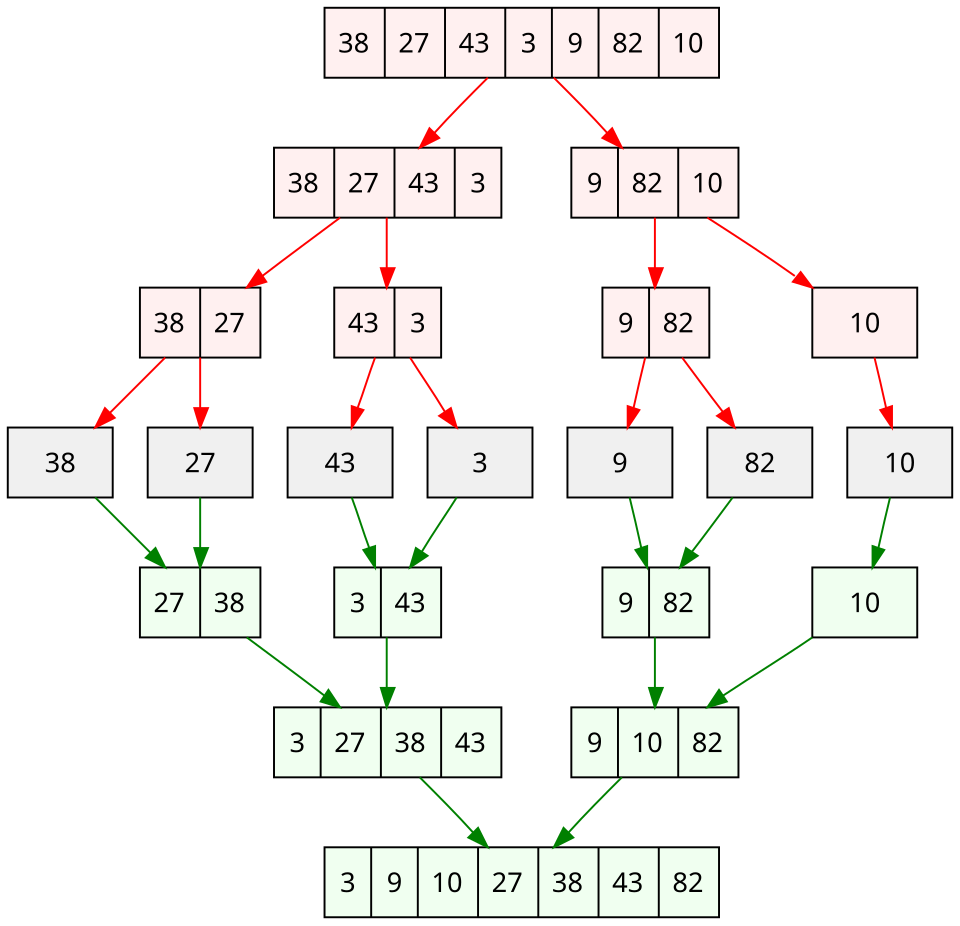
그림 출처: Wikimedia Commons (퍼블릭 도메인)
같은 과정을 애니메이션으로 보면, 작은 조각이 정렬된 채로 점점 큰 덩어리로 합쳐지는 것을 볼 수 있습니다.
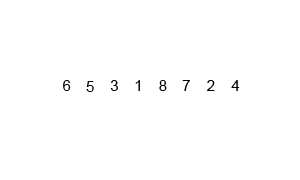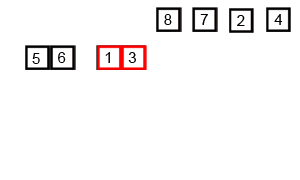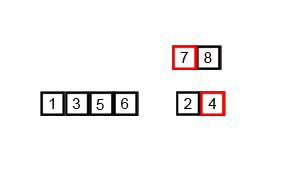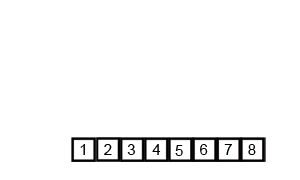
그림 출처: Wikimedia Commons (CC BY-SA 3.0, Swfung8)
Python 코드
원문의 mergeSort, merge 두 함수를 그대로 Python으로 옮겼습니다. left, right는 정렬할 구간의 양 끝 인덱스(끝 포함)입니다.
def merge_sort(array, left, right):
    # 1. 칸이 2개 이상일 때만 쪼갭니다 (1개면 이미 정렬된 상태)
    if left < right:
        mid = (left + right) // 2
        # 2. 왼쪽 절반과 오른쪽 절반을 각각 정렬합니다
        merge_sort(array, left, mid)
        merge_sort(array, mid + 1, right)
        # 3. 정렬된 두 절반을 하나로 합칩니다
        merge(array, left, mid, right)


def merge(array, left, mid, right):
    # 4. 두 영역을 따로 복사해 둡니다
    L = array[left:mid + 1]
    R = array[mid + 1:right + 1]

    i = j = 0
    k = left
    # 5. 두 영역의 맨 앞끼리 비교해 작은 값을 먼저 채웁니다
    while i < len(L) and j < len(R):
        if L[i] <= R[j]:          # 같으면 왼쪽 먼저 → 안정 정렬
            array[k] = L[i]
            i += 1
        else:
            array[k] = R[j]
            j += 1
        k += 1

    # 6. 한쪽이 먼저 끝나면 남은 값을 그대로 붙입니다
    while i < len(L):
        array[k] = L[i]
        i += 1
        k += 1
    while j < len(R):
        array[k] = R[j]
        j += 1
        k += 1


array = [230, 10, 60, 550, 40, 220, 20]
merge_sort(array, 0, len(array) - 1)
print(array)
# 출력: [10, 20, 40, 60, 220, 230, 550]
left < right일 때만 진행합니다. 구간에 원소가 하나뿐이면 더 할 일이 없습니다.- 가운데
mid를 기준으로 왼쪽[left, mid], 오른쪽[mid + 1, right]를 재귀로 각각 정렬합니다. - 양쪽이 정렬된 뒤에
merge로 합칩니다. 정렬 로직의 핵심은 이merge()입니다. - 원래 배열에 결과를 덮어써야 하므로, 두 영역을
L,R로 먼저 복사해 둡니다. 이 복사본 때문에 추가 메모리가 필요합니다. L과R의 맨 앞끼리 비교해서 작은 값을array[k]에 넣습니다.<=를 써서 값이 같으면 왼쪽(원래 앞에 있던 값)을 먼저 넣기 때문에 안정 정렬이 됩니다.- 한쪽을 다 쓰면, 다른 쪽에 남은 값들은 이미 정렬되어 있으므로 그대로 뒤에 붙입니다.
시간복잡도와 공간복잡도
| 경우 | 시간복잡도 |
|---|---|
| 최선 | Ω(n log n) |
| 평균 | Θ(n log n) |
| 최악 | O(n log n) |
- 배열을 반씩 나누므로 나누는 단계가 log n층 생기고, 각 층에서 합치는 작업은 전체 n개를 한 번씩 훑는 O(n)입니다. 그래서 입력이 어떻게 생겼든 항상 n log n입니다. (시간 복잡도 글 참고)
- 공간복잡도: 배열 기준 추가 메모리 O(n) (합칠 때 쓰는 임시 배열
L,R) + 재귀 호출 스택 O(log n)입니다. 연결 리스트라면 노드의 연결만 바꿔서 합칠 수 있어 임시 배열이 필요 없습니다.
연결 리스트(LinkedList) 정렬에 유리한 이유
병합 정렬은 순차적인 비교로 정렬을 진행하므로, 연결 리스트를 정렬해야 할 때 사용하면 효율적입니다.
연결 리스트를 퀵 정렬로 정렬하면 어떨까요?
- 성능이 좋지 않습니다.
- 퀵 정렬은 좋은 피벗(가운데 값 등)을 고르거나, 양 끝에서 포인터를 좁혀 오며 교환하는 등 원하는 위치로 바로 가는 임의 접근을 많이 쓰기 때문입니다.
연결 리스트는 삽입, 삭제 연산에서는 유용하지만 접근 연산에서는 비효율적입니다.
- 배열은 인덱스로 바로 접근할 수 있지만, 연결 리스트는 Head부터 하나씩 따라가며 찾아야 합니다.
- 접근 비용: 배열 O(1) vs 연결 리스트 O(n)
따라서 임의로 접근하는 퀵 정렬을 연결 리스트에 쓰면 오버헤드가 커집니다. 반면 병합 정렬의 merge는 두 리스트의 맨 앞만 보면서 앞으로 한 칸씩 나아가면 되므로, 연결 리스트와 잘 맞습니다.
Mini Git에서 써 보기
아래는 Mini Git 과제에서 정렬을 직접 구현할 때 정리한 내용입니다.
sorted(), list.sort() 금지! 직접 만듭니다. 추천은 병합 정렬(merge sort):
원리: "절반씩 쪼개서 각각 정렬한 뒤, 두 덩어리를 순서대로 섞기"
[38, 27, 43, 10]
   ├→ [38, 27] → [27, 38]
   └→ [43, 10] → [10, 43]
섞기 → [10, 27, 38, 43]def merge_sort(items, compare):
"""compare 함수 기준으로 items를 정렬하는 병합 정렬"""
if len(items) <= 1:
return items # 원소 1개면 이미 정렬됨
mid = len(items) // 2
left = merge_sort(items[:mid], compare) # 왼쪽 절반 정렬
right = merge_sort(items[mid:], compare) # 오른쪽 절반 정렬
merged = [] # 두 덩어리를 섞는 중
i = j = 0
while i < len(left) and j < len(right):
if compare(left[i], right[j]) <= 0: # 왼쪽이 작거나 같으면
merged.append(left[i]); i += 1
else:
merged.append(right[j]); j += 1
return merged + left[i:] + right[j:] # 남은 것들 붙이기설명용 지식 (과제 목표):
| 알고리즘 | 평균 | 최악 | 안정 정렬? |
|---|---|---|---|
| merge sort | O(n log n) | O(n log n) | O (안정) |
| quick sort | O(n log n) | O(n²) | X |
| bubble sort | O(n²) | O(n²) | O |
안정 정렬 = 값이 같은 원소끼리는 원래 순서가 유지되는 정렬. 비교 기준 교체: compare = lambda a, b: a.timestamp - b.timestamp 처럼 기준 함수만 바꿔서 같은 merge_sort 재사용.
정리
| 개념 | 비전공자 버전 요약 |
|---|---|
| 병합 정렬 | 반으로 계속 쪼갠 뒤, 정렬된 묶음 두 개를 맨 앞끼리 비교하며 합치기 |
| 분할 정복 | 큰 문제를 작은 문제로 쪼개서 풀고 다시 합치기 |
| 안정 정렬 | 값이 같으면 원래 순서를 그대로 지킴 |
| 연결 리스트 정렬 | 앞에서부터 차례로만 보면 되므로 병합 정렬이 잘 맞음 |
| merge sort | 절반씩 쪼개 정렬 후 섞기. 빠르고 안정적 |
출처: Codyssey-B1/B5-2