
퀵 정렬 (Quick Sort)
퀵 정렬은 기준값(피벗) 하나를 정해 작은 값은 왼쪽, 큰 값은 오른쪽으로 나눈 뒤, 양쪽을 같은 방법으로 다시 정렬하는 정렬입니다. 평균적으로 가장 빠른 정렬 중 하나입니다.
한눈에 보기
- 퀵 정렬은 분할 정복(divide and conquer) 방법으로 배열을 정렬합니다.
- 분할 정복: 문제를 작은 2개의 문제로 나누고, 각각을 해결한 다음, 결과를 모아 원래 문제를 해결하는 전략입니다.
- 비유: 반 학생들을 키 순서로 세울 때, 한 명(피벗)을 기준으로 "나보다 작은 사람은 왼쪽, 큰 사람은 오른쪽"으로 먼저 가릅니다. 그러면 기준 학생의 자리는 확정되고, 왼쪽 무리와 오른쪽 무리를 각각 같은 방법으로 다시 가르면 됩니다.
- 분류로 보면 다른 원소와의 비교만으로 정렬하는 비교 정렬이고, 같은 값의 순서가 바뀔 수 있는 불안정 정렬입니다.
- 병합 정렬은 배열을 항상 절반으로 나누지만, 퀵 정렬은 피벗이 어떤 값이냐에 따라 비균등하게 나눕니다.
동작 과정
오름차순 정렬 기준입니다.
- 배열에서 원소 하나를 고릅니다. 이 원소를 피벗(pivot) 이라고 합니다.
- 피벗 앞에는 피벗보다 작은 원소들이, 피벗 뒤에는 피벗보다 큰 원소들이 오도록 배열을 둘로 나눕니다. 이것을 분할(Divide) 이라고 합니다. (피벗과 같은 값은 아래 코드에서는 왼쪽으로 갑니다.) 분할이 끝나면 피벗은 더 이상 움직이지 않습니다.
- 나뉜 두 개의 작은 배열에 대해 이 과정을 재귀(Recursion)적으로 반복합니다.
- 재귀 호출이 한 번 진행될 때마다 최소한 원소 하나(피벗)는 최종 위치가 정해지므로, 이 알고리즘은 반드시 끝난다는 것을 보장할 수 있습니다.
예시 배열 [4, 7, 2, 6, 1, 3]을 아래 Python 코드(맨 왼쪽 값을 피벗으로 사용)로 따라가 보겠습니다. i는 왼쪽에서 "피벗보다 큰 값"을, j는 오른쪽에서 "피벗 이하인 값"을 찾아 서로 바꿉니다.
| 단계 | 구간 / 피벗 | 배열 상태 | 설명 |
|---|---|---|---|
| 시작 | 전체 / 4 | [4, 7, 2, 6, 1, 3] | 맨 왼쪽 4를 피벗으로 |
| 1 | 전체 / 4 | [4, 3, 2, 6, 1, 7] | j는 3에서 멈춤, i는 7에서 멈춤 → 7과 3 교환 |
| 2 | 전체 / 4 | [4, 3, 2, 1, 6, 7] | j는 1에서, i는 6에서 멈춤 → 6과 1 교환 |
| 3 | 전체 / 4 | [1, 3, 2, 4, 6, 7] | i와 j가 만남. 그 자리의 1과 피벗 4를 교환 → 4 확정 |
| 4 | 왼쪽 [1, 3, 2] / 1 | [1, 3, 2, 4, 6, 7] | 1보다 작은 값이 없어 1이 그대로 확정 |
| 5 | [3, 2] / 3 | [1, 2, 3, 4, 6, 7] | 2와 3 자리 교환 → 3 확정 |
| 6 | 오른쪽 [6, 7] / 6 | [1, 2, 3, 4, 6, 7] | 6 확정, 7은 혼자라 끝. 정렬 완료 |
그림으로 보기
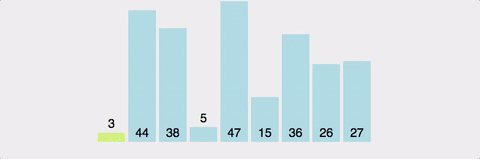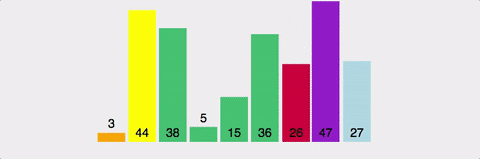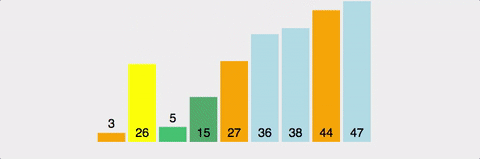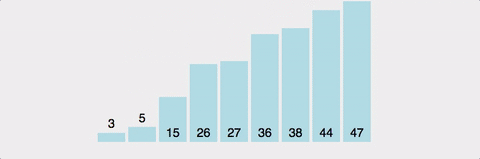
그림 출처: GimunLee/tech-refrigerator (Apache-2.0)
Python 코드
퀵 정렬은 다음 두 단계로 이루어집니다.
정복 (Conquer)
부분 배열을 정렬합니다. 부분 배열의 크기가 충분히 작지 않으면 재귀 호출로 다시 분할 정복을 적용합니다.
def quick_sort(arr, left=0, right=None, use_mid=False):
    """피벗 기준으로 나눈 뒤 양쪽을 재귀로 정렬하는 퀵 정렬 (오름차순)"""
    if right is None:
        right = len(arr) - 1
    if left >= right:                              # 1.
        return arr
    pivot = partition(arr, left, right, use_mid)   # 2.
    quick_sort(arr, left, pivot - 1, use_mid)      # 3.
    quick_sort(arr, pivot + 1, right, use_mid)
return arr- 구간에 원소가 0개나 1개면 이미 정렬된 것이므로 바로 끝냅니다.
- 분할:
partition으로 구간을 나누고, 자리가 확정된 피벗의 위치를 받습니다. - 정복: 피벗을 뺀 왼쪽 부분 배열과 오른쪽 부분 배열을 각각 재귀 호출로 정렬합니다.
분할 (Divide)
입력 배열을 피벗 기준으로 비균등하게 2개의 부분 배열 (피벗 왼쪽: 피벗보다 작거나 같은 값들, 오른쪽: 피벗보다 큰 값들) 로 나눕니다.
def partition(arr, left, right, use_mid=False):
    """맨 왼쪽 값을 피벗으로 구간을 둘로 나누고, 피벗의 최종 위치를 돌려준다"""
    if use_mid:                                    # 1.
        mid = (left + right) // 2
        arr[left], arr[mid] = arr[mid], arr[left]
    pivot = arr[left]                              # 2.
    i, j = left, right
    while i < j:
        while pivot < arr[j]:                      # 3.
            j -= 1
        while i < j and pivot >= arr[i]:           # 4.
            i += 1
        arr[i], arr[j] = arr[j], arr[i]            # 5.
    arr[left] = arr[i]                             # 6.
    arr[i] = pivot
    return i


# quick_sort와 partition을 함께 정의한 뒤 실행합니다.
print(quick_sort([4, 7, 2, 6, 1, 3]))
# 출력: [1, 2, 3, 4, 6, 7]
print(quick_sort([1, 2, 3, 4, 5, 6, 7], use_mid=True))
# 출력: [1, 2, 3, 4, 5, 6, 7]- 최악의 경우를 피하는 개선 방법입니다.
use_mid=True면 가운데 위치의 값을 맨 왼쪽으로 옮겨서 피벗으로 씁니다. (원문 Java 코드에서는 주석 처리되어 있던 부분입니다. 자세한 내용은 아래 "최악의 경우 개선하기" 참고) - 맨 왼쪽 값을 피벗으로 정하고,
i는 왼쪽 끝,j는 오른쪽 끝에서 출발합니다. j를 왼쪽으로 옮기며 피벗 이하인 값을 찾습니다. 맨 왼쪽에 피벗 자신이 있으므로j가 구간 밖으로 나가지 않습니다.i를 오른쪽으로 옮기며 피벗보다 큰 값을 찾습니다.i가j를 넘어가지 않게i < j도 함께 확인합니다.- 찾은 두 값을 바꿔서, 작은 값은 왼쪽으로, 큰 값은 오른쪽으로 보냅니다.
i와j가 만날 때까지 3~5를 반복합니다. - 만난 자리의 값(피벗 이하인 값)을 맨 왼쪽으로 보내고, 그 자리에 피벗을 넣습니다. 이제 피벗 왼쪽은 모두 피벗 이하, 오른쪽은 모두 피벗보다 큽니다.
Python에서 재귀 깊이 주의
Python은 기본 재귀 깊이 제한이 약 1000입니다. 맨 왼쪽 피벗을 그대로 쓰면 이미 정렬된 배열 1000개 이상에서 재귀가 원소 수만큼 깊어져 RecursionError가 납니다. use_mid=True로 가운데 값을 피벗으로 쓰면 정렬된 배열도 절반씩 나뉘어 문제없이 동작합니다.
최악의 경우 개선하기
partition()에서 피벗이 구간의 최솟값이나 최댓값으로 정해져 한쪽으로만 나뉘면, 시간복잡도가 O(n²)이 됩니다.
즉, 맨 왼쪽 값을 피벗으로 쓰는 위 코드는 배열이 이미 오름차순이나 내림차순으로 정렬되어 있으면 O(n²)입니다. 이때 맨 앞 값과 가운데 위치의 값을 바꾼 뒤 피벗으로 쓰면(use_mid=True), 정렬된 배열에서도 고르게 나뉘어 대부분의 경우 O(n log₂ n)으로 개선할 수 있습니다. 하지만 이렇게 개선해도 퀵 정렬의 최악 시간복잡도가 O(n log₂ n)이 되는 것은 아닙니다. 가운데 값이 하필 최솟값이나 최댓값이 되도록 짜인 배열에서는 여전히 O(n²)입니다. 피벗을 무작위로 고르는 방법도 널리 쓰이지만, 이 역시 최악을 없애 주지는 않고 최악이 나올 확률을 매우 낮춰 줄 뿐입니다.
시간복잡도와 공간복잡도
최선의 경우 : T(n) = O(n log₂ n)
재귀 호출의 깊이
(log₂ n)레코드 개수 n이 2의 거듭제곱이라고 가정(n = 2^k)해 보겠습니다. n = 2³이면 피벗이 매번 정확히 절반으로 나눌 때 2³ → 2² → 2¹ → 2⁰ 순으로 줄어들어 재귀 호출의 깊이가 3이 됩니다.
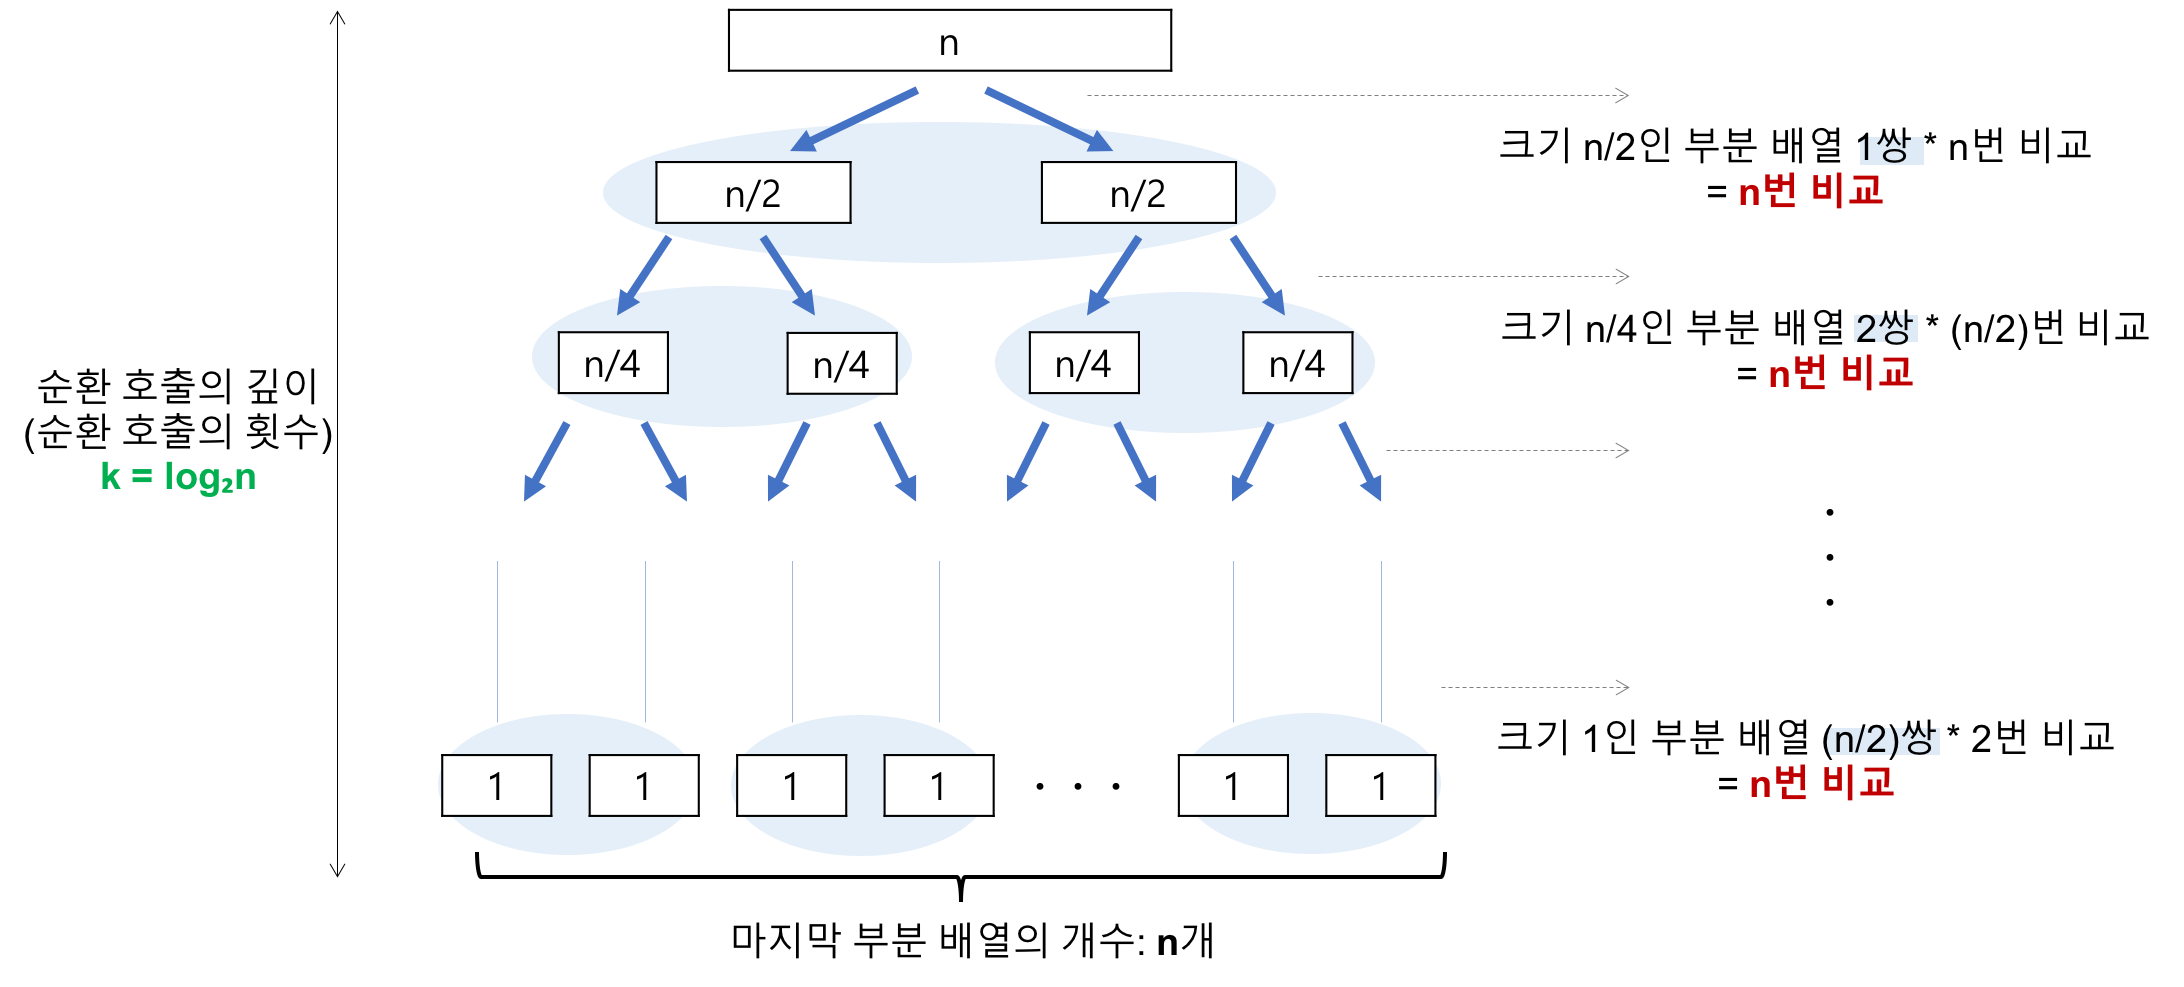
그림 출처: GimunLee/tech-refrigerator (Apache-2.0)
이것을 일반화하면 n = 2^k일 때 깊이는 k (k = log₂ n) 입니다.
각 재귀 호출 단계의 비교 연산
(n)각 단계에서는 전체 리스트의 거의 모든 레코드를 비교해야 하므로 평균 n번 정도 비교합니다.
따라서 최선의 시간복잡도는 재귀 호출의 깊이 × 각 단계의 비교 연산 = n log₂ n입니다. 이동(교환) 횟수는 비교 횟수보다 적으므로 무시할 수 있습니다.
최악의 경우 : T(n) = O(n²)
최악의 경우는 피벗이 매번 최솟값이나 최댓값이 되는 경우입니다. 맨 왼쪽 값을 피벗으로 쓰면, 정렬하려는 배열이 이미 오름차순이나 내림차순으로 정렬된 경우가 여기에 해당합니다. (위 코드는 모든 값이 같은 배열도 한쪽으로만 나뉘어 최악이 됩니다.)
재귀 호출의 깊이
(n)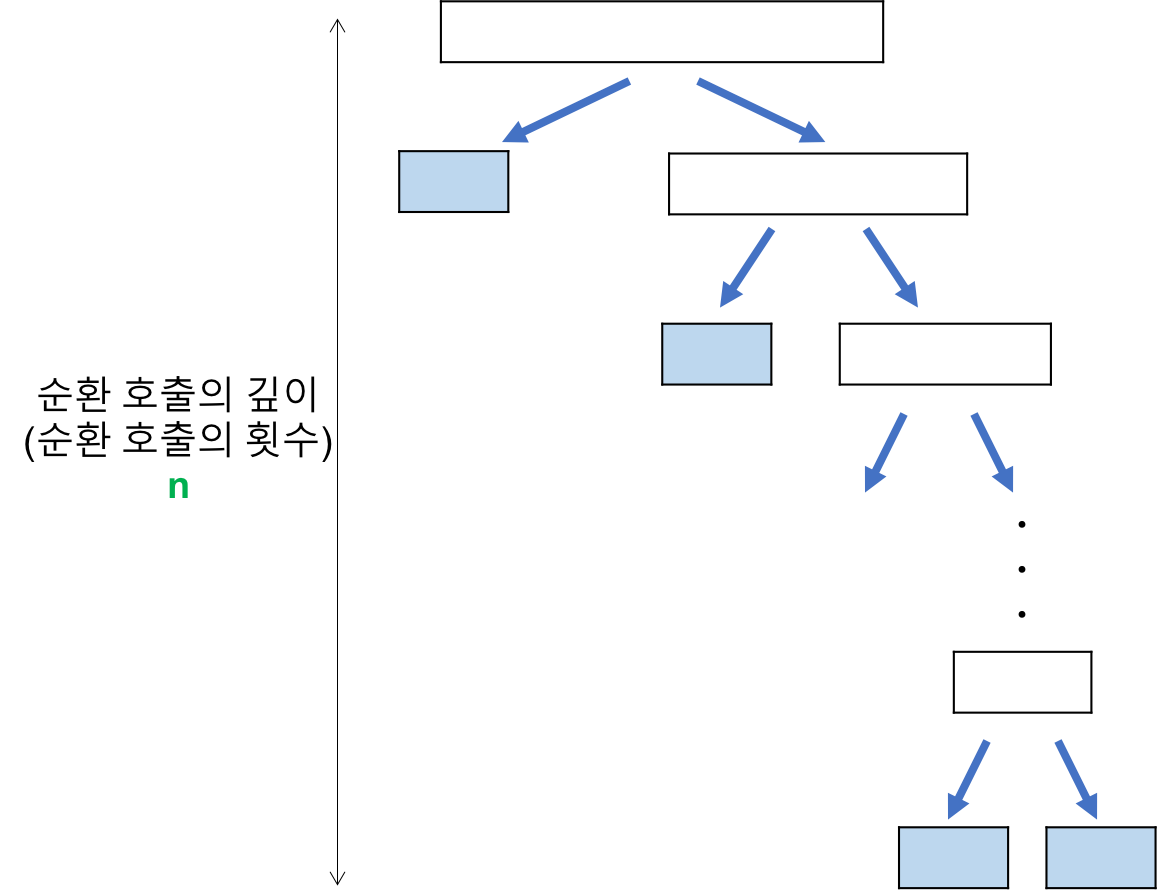
그림 출처: GimunLee/tech-refrigerator (Apache-2.0)
한 번 나눌 때마다 원소가 1개씩만 줄어들므로 재귀 호출의 깊이는 n입니다.
각 재귀 호출 단계의 비교 연산
(n)각 단계에서는 전체 리스트의 거의 모든 레코드를 비교해야 하므로 평균 n번 정도 비교합니다.
따라서 최악의 시간복잡도는 재귀 호출의 깊이 × 각 단계의 비교 연산 = n²입니다. 이동 횟수는 비교 횟수보다 적으므로 무시할 수 있습니다.
평균의 경우 : T(n) = O(n log₂ n)
무작위 배열이라면 피벗이 한쪽 끝에 몰리는 일이 드물어서, 평균적으로 최선의 경우와 같은 O(n log₂ n)이 됩니다.
경우별 정리
| 경우 | 시간복잡도 |
|---|---|
| 최선 | O(n log n) |
| 평균 | O(n log n) |
| 최악 | O(n²) |
| 공간 | 재귀 호출 스택: 평균 O(log n), 최악 O(n) |
- 공간: 배열 안에서 교환만 하므로 따로 배열을 만들지는 않습니다. 하지만 재귀 호출이 쌓이는 만큼 메모리를 쓰기 때문에, 추가 메모리는 재귀 깊이와 같은 평균 O(log n), 최악 O(n) 입니다. (두 부분 중 작은 쪽을 먼저 재귀하고 큰 쪽은 반복문으로 처리하면 최악에도 O(log n)으로 줄일 수 있습니다.)
- O 표기법은 시간 복잡도 글을 참고하세요.
장점과 단점
장점
- 불필요한 데이터 이동을 줄이고 먼 거리의 데이터를 한 번에 교환하며, 한 번 자리가 정해진 피벗은 이후 연산에서 빠지기 때문에, 같은 O(n log n) 정렬들과 비교해도 실제로는 가장 빠른 편입니다.
- 정렬할 배열 안에서 교환하는 방식이라 별도의 배열을 만들 필요가 없습니다. (재귀 호출 스택만 추가로 씁니다.)
단점
- 불안정 정렬(Unstable Sort) 입니다.
- 이미 정렬된 배열에서는 불균형하게 나뉘어서 오히려 수행 시간이 더 오래 걸립니다. (피벗을 맨 왼쪽 값으로 고를 때)
불안정한 예를 하나 보겠습니다. 같은 값 2 두 개를 2a, 2b라고 이름 붙입니다.
| 단계 | 배열 상태 | 설명 |
|---|---|---|
| 시작 | [2a, 2b, 1] | 2a가 2b보다 앞. 피벗은 2a |
| 분할 | [1, 2b, 2a] | i와 j가 맨 끝(1)에서 만나고, 1과 피벗 2a를 교환 |
정렬은 끝났지만 2a와 2b의 순서가 뒤집혔습니다.
마무리
평균적으로 가장 빠른 정렬 알고리즘 중 하나인 퀵 정렬을 알아봤습니다. Java의 Arrays.sort()도 int[] 같은 기본형 배열에는 Dual-Pivot Quick Sort(피벗을 2개 쓰는 퀵 정렬)를 쓸 만큼 효율적인 알고리즘입니다. (객체 배열에는 안정 정렬인 Timsort를 씁니다.) 기술 면접에서 정말 자주 나오는 주제이므로 꼭 익혀 두는 것이 좋습니다. 최악에도 O(n log n)을 보장하는 정렬이 필요하면 병합 정렬이나 힙 정렬을 함께 보세요.
정리
| 개념 | 비전공자 버전 요약 |
|---|---|
| 퀵 정렬 | 기준 한 명을 세우고 작은 쪽, 큰 쪽으로 갈라 각각 다시 정렬 |
| 피벗 | 편을 가르는 기준값. 가르고 나면 자기 자리 확정 |
| 분할 정복 | 큰 문제를 작게 쪼개 풀고 합치기 |
| 최악의 경우 | 기준이 늘 맨 끝 값이면 한쪽으로만 갈라져 느려짐 |
| 가운데 피벗 | 정렬된 배열에서도 반씩 나뉘도록 기준을 가운데서 고르기 |
출처: GimunLee/tech-refrigerator (Apache-2.0), 코드는 Python으로 다시 작성
참고: jinhyy - 정렬 알고리즘